CS230 C4W3&4:CNN应用——人脸识别,物体探测与风格转换以及背后的原理
CS230 C4W3&4:CNN应用——人脸识别,物体探测与风格转换以及背后的原理
之前我们了解了CNN设计的常见思路,而接下来我们将会介绍人脸识别,图像识别等方面一些特别的设计结构,并由此对CNN中的卷积 有更深刻的理解。
人脸识别#
Problem#
我们有一个由人脸照片组成的一个数据库,每人都只有一张图片记录 ,我们输入一张图片,希望能判断这个图片上的人是否在这些人脸中
One-shot Learning#
对于这个问题的第一反应肯定是对两个图片直接计算范数,但是这个肯定是不可以的。因为外部的环境(白天,晚上等)会让图片看上去非常的不一样。
同时我们注意到如果使用独热编码 的话,网络每一次的输出都是通过一个softmax得到一个结果的话,那么每次输入一个人都要重新训练这个网络,收益太低。而且我们对于一个人只有一张图片,无法进行大规模的训练。
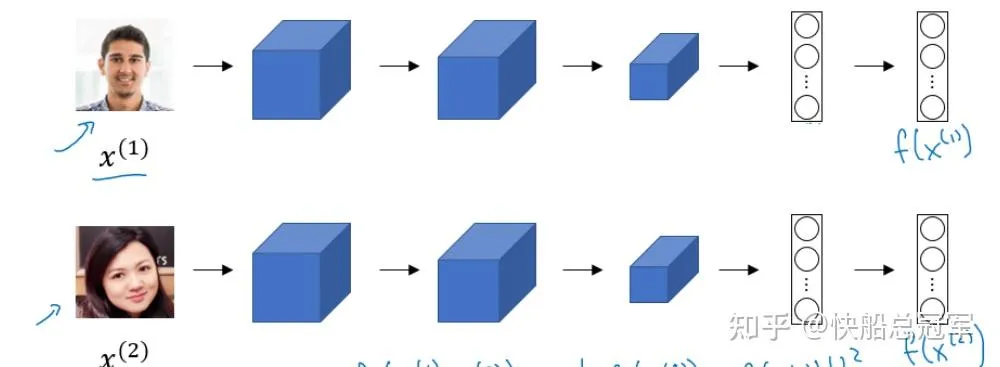
于是我们网络的目标是:可以提取一张图片上关于人脸的信息,以较高的正确率与其他人的照片进行比较 ,借鉴身份证 的想法,我们可以考虑将每张人脸转换成一个向量 进行比较
Siamese Network#
siamese Network就是使用这样的方法,它可以将每一张输入的人脸经过一个CNN之后,不是最后用softmax进行分类,而是直接使用最后FC的输出(高维向量) 来表示人脸的信息
假设对于输入 时输出向量为 ,我们对于不同图片的比较,直接使用范数比较 。
- 若 ,那么表示这两个人的脸非常像,可以认为是同一个人
- 若 ,可以认为不是同一个人
对于训练这个网路的时候,我们希望 可以对长相相近的人的图片进行奖励,而对于长相不同的进行乘法。于是对于每一组的训练数据,由人A的图片 ,A的另外一张图片 ,以及另外一个人的图片 组成
损失函数 就可以做到奖励相同惩罚不同。
将若干组 输入到网络中,经过训练之后得到网络 ,而预测的时候只要输入一个图片 ,将 与数据库中的东西进行比较
图像形式转换#
举个例子,我们希望有一张梵高的图片,还有一张USTC的照片,我们想要用梵高作画的风格去画USTC的这个画, 希望可以编写一个网络去实现。
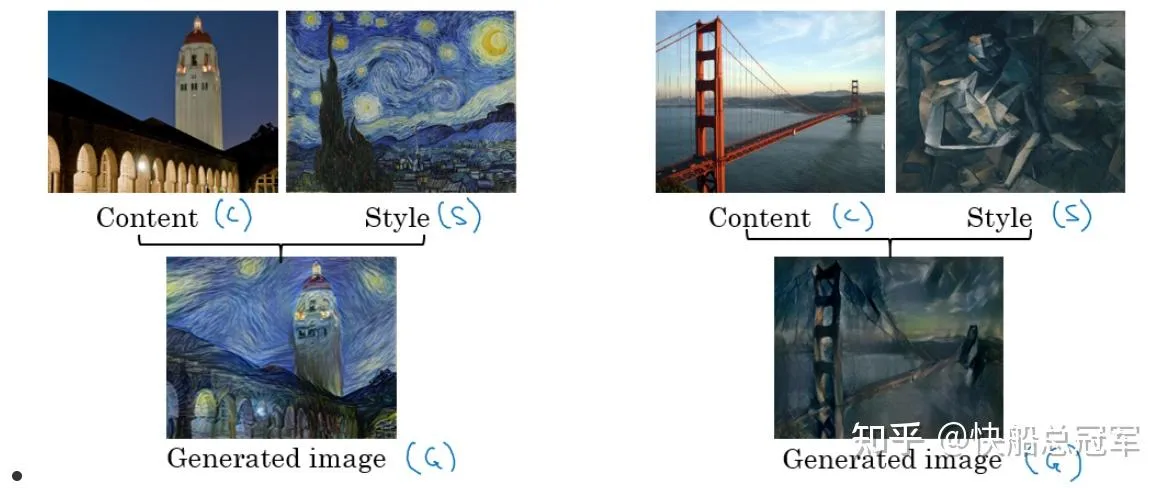
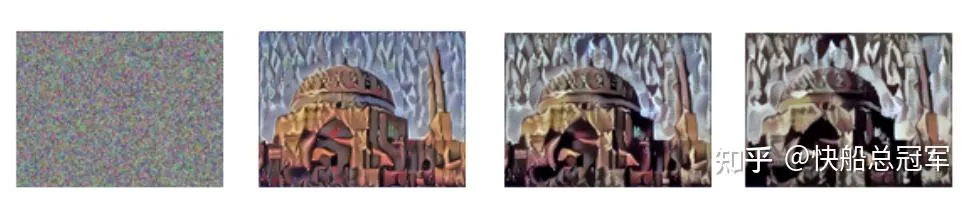
由于我们学过了MIT 6.S184了,我们在产生图片的时候,仍然是想要让图片从原始的噪声变成符合要求的状态,虽然本题我们不会使用扩散模型(虽然也可以,对于那张梵高的图片以及USTC变成条件y,然后进行图片生成,但是过于麻烦了。)
问题思路#
我们发现** 风格&内容**都是物体的特征,只是这个是不同方面的,考虑到这些都是通过图片去进行提取的,使用CNN去进行这个方面的提取即可。
结合扩散模型的变化的思路,我们的思路就是
- 从噪声出发,沿着某个CNN,直到某一层,设计一个损失函数 来比较三张图片
- 不是对参数进行梯度下降,而是对于目前的图片Present进行梯度下降,每一个iteration对于当前的图片进行调整,使得损失函数更小
- 最后得到想要的图片。
称我们当前的图片为 ,风格图片为 ,内容图片为 ,则损失函数为
Content Cost Function#
评价我们想要生成的图片的内容,对于内容而言,风格的变化不会带来非常巨大的差距。
于是我们网络的话可以使用迁移性能较好的VGG,生成过程中,对于C,G中的第l层输出 使用 可以衡量这个作为内容上的差异。
从而为每一层添加一个权重 即为我们的内容损失函数
Style Cost Function#
首先我们需要明确风格是什么,两张图片都是由梵高画的,如果将他们分别拆分成对应的RGB三原色,对于** 一张图片三种颜色的组合方式应该和另外一张相同**,而组合方式翻译过来也就是** 相同位置,不同通道之间的关系**.
于是我们的风格也就是不同通道之间的关系。对于不同通道之间的关系,可以认为每一个通道对应的2D图片都是空间上的一个向量,如果我们的关系比较接近,我们的方向应该相同。只是我们的空间维度为
维的。而方向就是点乘。于是对于一张图片 表示网络的第l层,ij为像素点在图片上的位置坐标,k表示这是第几个channel,Gram Matrix 为 即为描述第k和k’个通道的关系。
而我们第l层的Style Cost Function为
,最后的损失函数为
将以上的内容整合起来就可以对于图片进行风格上的转换了。
物体识别#
问题描述#
对于一张图片,我们希望能识别出来其中所有的汽车,飞机,行人…并且在其周围画上一个边框。
对于这个问题,我们可以拆分成若干个步骤(1)对于一个图片中只有一个物体时如何识别 (2)如何分别识别图片不同位置物体 (3) 图片有所重叠怎么办 (4)最后整合起来
One Picture&One object#
前面两个案例中,对于CNN都是使用了其提取特征的能力,而对于图片分类的话最后是使用softmax进行单个输出。而该问题中,显然输出y应该包含:(1)物体的边界 以及中心 (2)这张图片上有物体/没有物体 (3)如果有物体的话那么每一种物体的概率即为 这些输出。网络结构的话只要把最后一层的softmax改成一个全连接层。
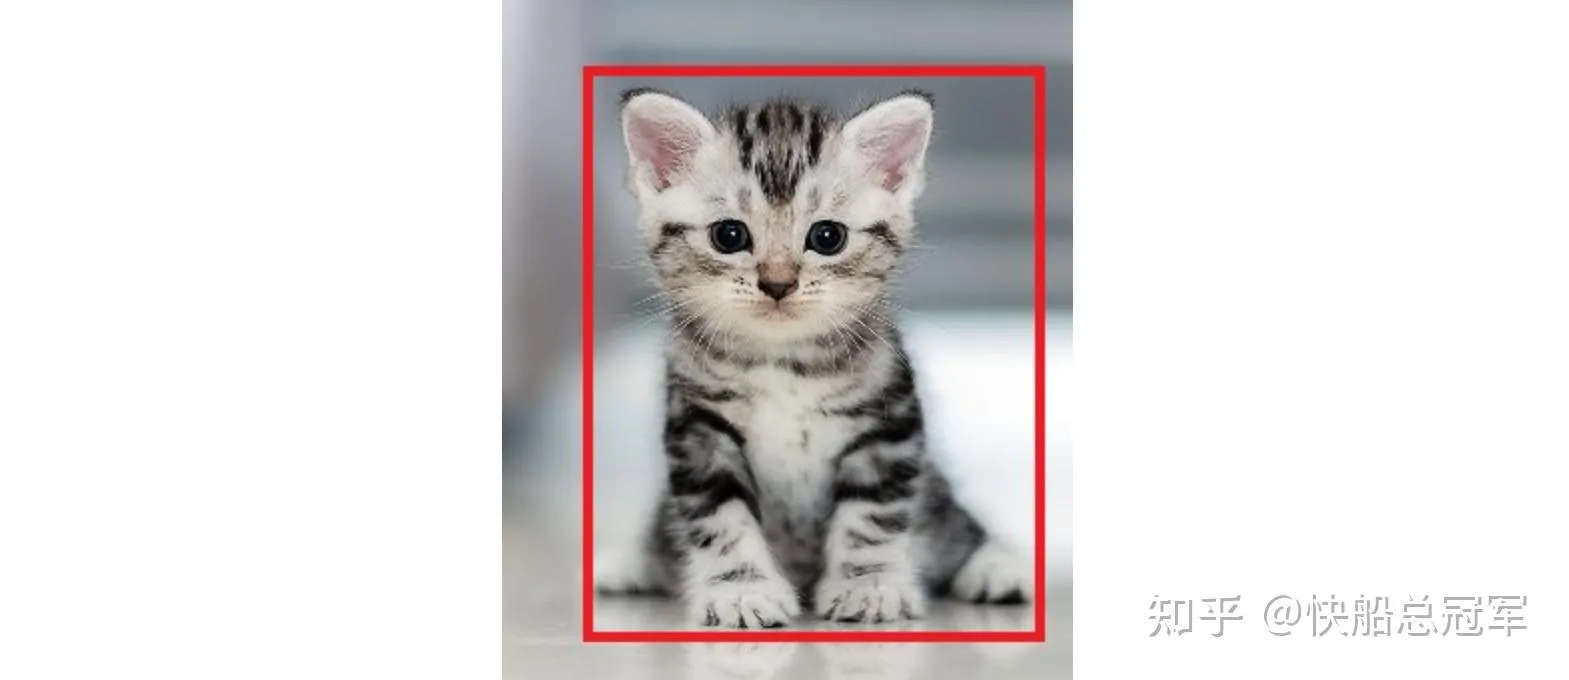
于是训练的时候只需要扔给网络一堆的这样的(图片,输出)的pair,** 将训练数据集做好**,然后进行梯度下降就可以了。(类似的,如果我们想要对于人脸的特征点进行采样,只要把相应的数据集做好即可进行训练)
我们如果要识别一张图片上的多个物体,一种想法是使用一个滑块,在图片上不断的移动,从而可以识别到不同位置的物体,但是如果实现(切割图片,输入,输出,处理得到结果)的话,非常耗费算力,相应的,我们可以直接将** 卷积核应用到整个图片上**,假设最一开始是一个 的图片,得到一个 的输出,将这个卷积神经网络应用到一个 的图片上,最后是一个 的输出,对于每一个 的卷积核都表示一个 区域对应的输出。
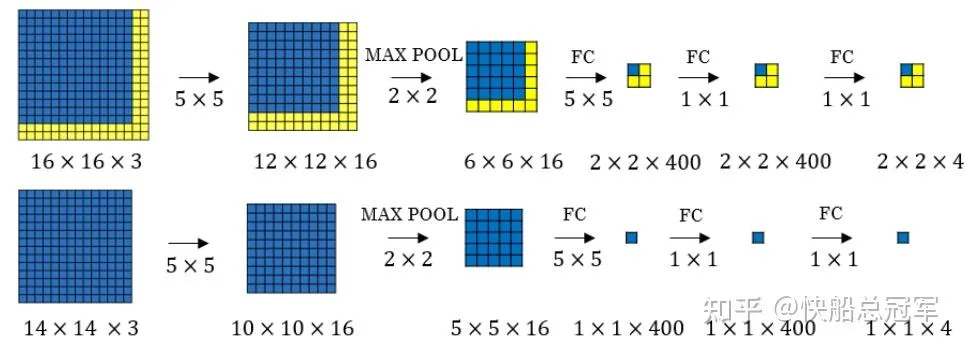
使用这种sliding window的方法可以精确的找到所有的物体,但是缺点是太耗费算力,而且由于太精确了,有可能画出来的框框不是我们想要的。
YOLO 算法#
YOLO是物体识别的主流算法,接下来就其15年的v1来介绍一下。
识别可能的物体#
YOLO v1的假设是对于一个图片上不会有一小块的位置上有特别特别多的需要识别的物体。
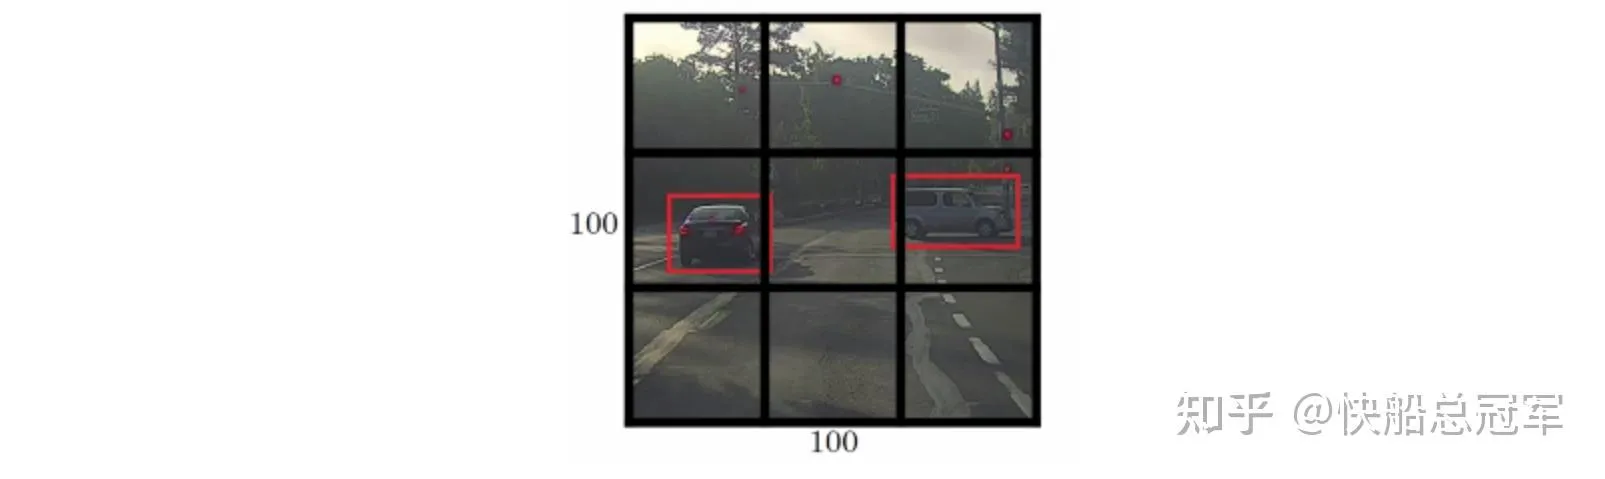
YOLO与sliding window不同,sliding window是将以1为stride进行移动,如果我们的视野域为 ,而图片大小为 ,那么总共就需要计算 次,这实在是太大了。而我们的YOLO算法是**将 的图片分割成 个”cell”**对于每一个cell(图片的一个局部)而言都进行物体的识别,最后得到一个 个物体的边框
合并区域#
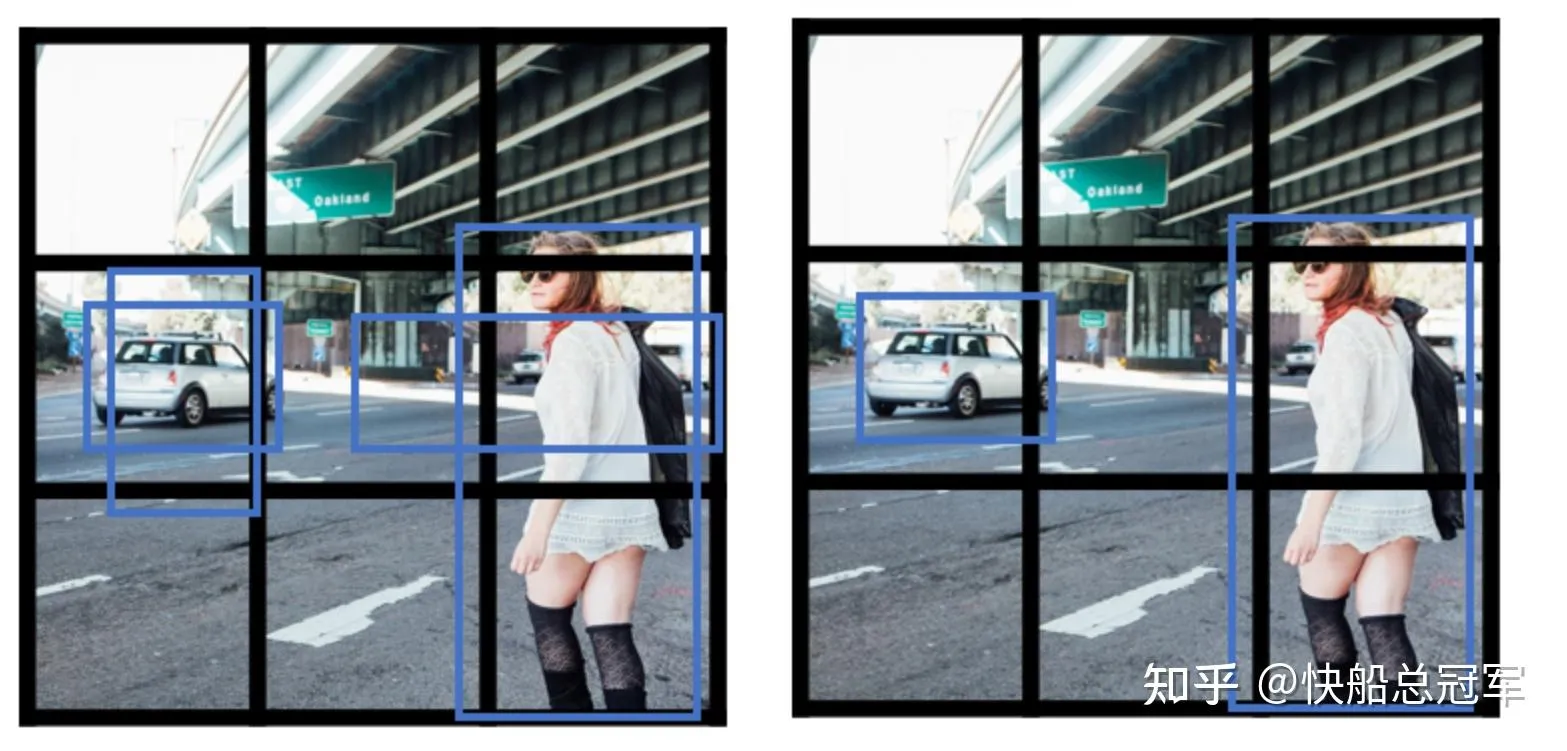
上一个步骤中我们每一个cell都会给出一个物的边框,但是如果有的物体在多个cell中都有出现,那么就需要对边框进行合并 。
为了判断那些边框可以进行合并,需要引入测算边框交叉部分的 ,其中 是两个边框的交叉部分面积, 是整体的面积。
假设我们现在来合并所有的种类为c的物体的边框
- 首先对于将所有的 的边框给拿出来,并且把别的边框给丢弃
- 从剩余的边框中取出来 最大的,将余下来的边框中满足 的边框给合并到这一个中
- 重复第二步,得到所有种类c的物体的边框,对于别的c而言采取同样的操作。
通过以上的步骤我们可以成功的对于边框进行合并。
单个cell多个物体#
有的时候,同一个cell中会出现多个物体,比如一个人站在汽车的前方,此时我们就需要对单个cell的输出进行一些改变。
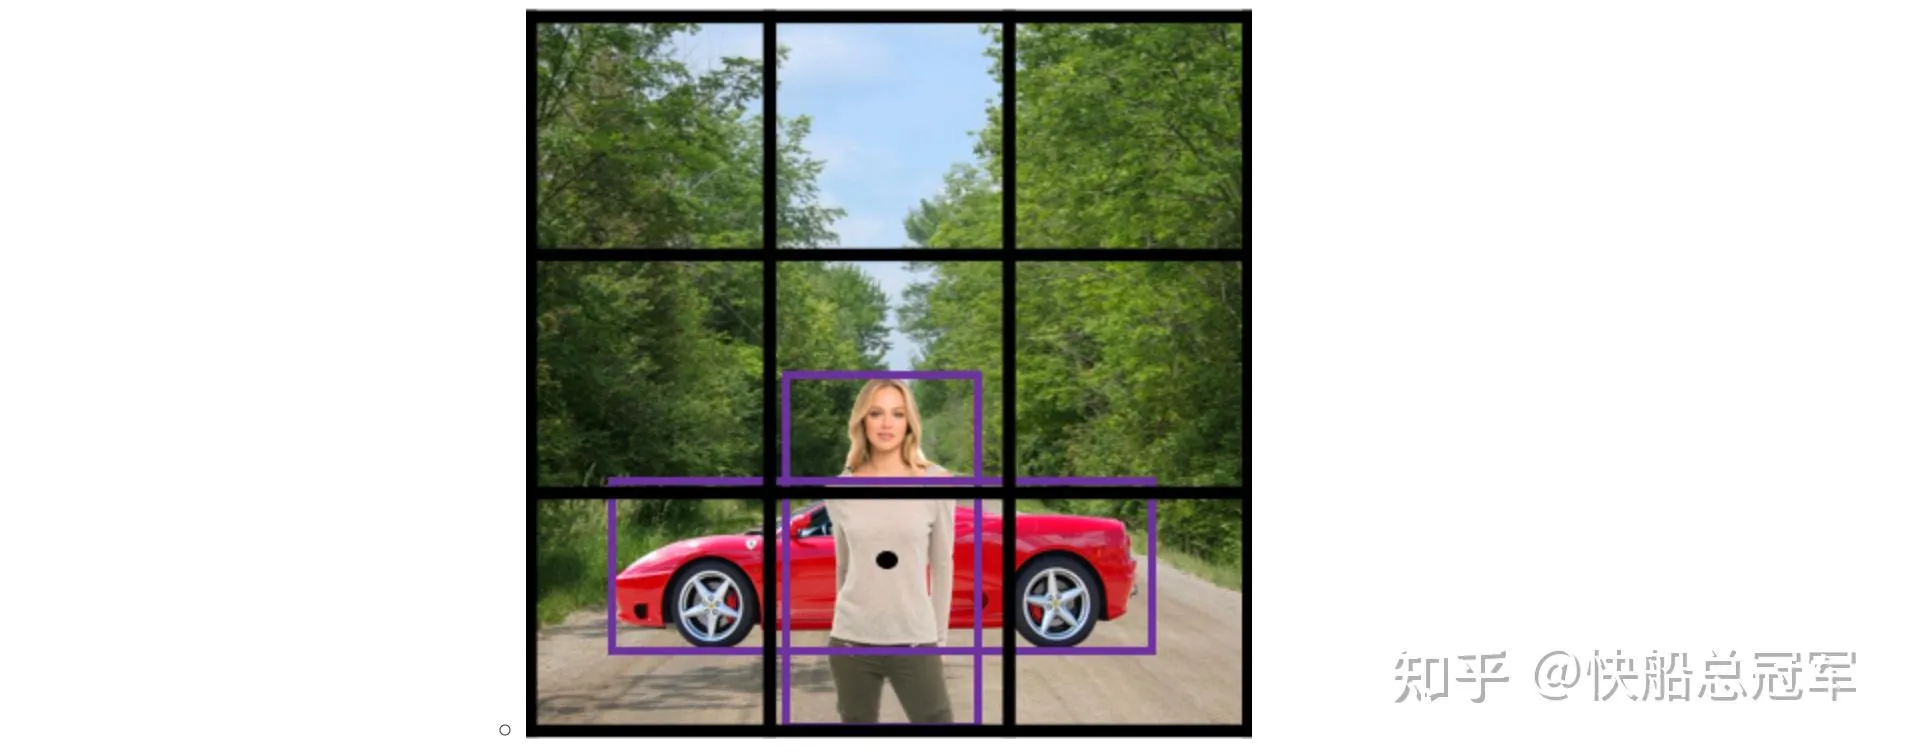
- 对于单个的cell,之前我们的输出为 ,而此时我们想要探测多个物体,只需要使用
即可
但是这样的问题是两个输出可能会探测到同一个物体上,而我们想要探测不同的物体,这两个物体又有不同的形状,结合上面的交叉部分探测的观点,可以事先规定若干个不同大小的anchor box, 存储和anchor box1的 的物体, 同理 。
最后我们只需要
- 首先对于每一个cell而言,得到若干个anchor box对应的边框
- 排除 的边框并进行合并操作
- 最后得到的就是就是我们的答案。
以上就是CNN在实际中的一些常见应用,可以发现CNN对于图形的特征提取 效果非常好,尤其是“从浅层到深层次提取深度不断增加”的想法,这种特征提取的思想是非常的关键的。