CS229最后介绍了强化学习的内容,与之前的规定了优化的方向以及最后的目标不同,强化学习是通过对机器的行为设定奖励并通过实验自行学习到最优的解决方案 的一种学习手段,接下来我们将会介绍最为基本的Markov Decision Process以及其常见的改进手段。
Basic MDP#
基本要素#
想要让机器知道对于那一步应该采取什么样的措施,我们需要对于机器在那一步做出什么样的行为设定合理的奖励 R ,我们需要预先知道机器** 可能的状态** S 并且规定好机器会做出的反应 A ,最后在机器进行决策的时候我们会有** 过往的经验矩阵 Psa(s′) 表示s状态下使用a操作会到达s’的概率, 最后对于 奖励计算**我们还会设置一个折扣值 γ 来衡量时间的因素。
以上便是MDP的基本要素, {S,A,Psa,γ,R} 变为我们所有的参数。对于训练寻找最优的策略 π 的过程中,总体的步骤为
- 初始化:最开始的状态为 S0 有 S0∼Ps0a0
- 步进:我们由此在 Ps0a0 (过往的经验)中以某种规则 选择步骤 a0 得到 s1 ,并以此类推,得到 s0a0s1a1s2a2s3a3⋯sn
- 调整策略:到了 sn 之后基于之前的行为对于 Psa 进行调整,然后继续步进。
- 直到最后 Psa 收敛,我们得到了一个合理的策略选择方案。
评价函数#
在步进中,我们已经有了可能进行选择的策略以及基于过往的经验的概率 Psa ,而此时对于场景 s0 而言,需要对不同的操作进行评估,并形成对于一个策略 π(s0) 。
对于 (s0,a0) 而言,如果之后我们的操作是 (s1,a1),(s2,a2)... 的话,对于整体的奖励函数进行累加,得到
L(S,A)=R(s0,a0)+R(s1,a1)+R(s2,a2)+....
考虑到时间的因素,我们对于 s1,s2 都是假设之后的状态以及做出的动作,应该加上一个因子来衡量时间的影响
L(S,A)=R(s0,a0)+γR(s1,a1)+γ2R(s2,a2)+....
常常我们的损失只会与我们的状态有关,比如一个机器人如果倒地了那么就将损失定为-1,否则为0。而对于 a0
对于整体的影响为了简化问题不考虑。于是有
对于 s0 以及预测之后动作列 s1,s2,s3,... 的损失函数为
L(S)=R(s0)+γR(s1)+γ2R(s2)+γ3R(s3)...
从评价函数到策略选取#
对于 s0 处的损失取平均值,有 L(S)=E(R(s0)+γR(s1)+γ2R(s2)+γ3R(s3)...) 我们希望得到一个最合适的策略 a=π(s) 对于之后的步骤选取我们都使用这个策略,于是有定义
Vπ(s)=E[R(s0)+γR(s1)+γ2R(s2)+⋯s0=s,π]
该式子等价于 Vπ(s)=R(s)+γ∑s′∈SPsπ(s)(s′)Vπ(s′)
我们的策略是希望这个策略让损失最小,如果有 V∗(s)=maxπVπ(s) 的话,那么有 V∗(s)=R(s)+maxa∈Aγ∑s′∈SPsa(s′)V∗(s′) 该方程也称为Bellman equation
有了对于每一个步骤的评价函数,那么对于** 策略的选取**为
a∗=π∗(s)=argmaxa∈AV(s)=argmaxa∈A∑s′∈SPsa(s′)V∗(s′)
以上是数学上的一个推导,而我们对于具体的计算的话,我们发现 V∗(s)
解的话为一个线性方程组 ,如果直接求解会比较的慢,实际的使用中,一种常见的方法为value iteration
- Step 1 :首先将 V(s) 全部初始化为0
- Step 2 :重复步骤知道收敛,每一步中根据Bellman Equation对于 V(s) 进行更新。
对于之后的动作的选取为 π(s):=argmaxa∈A∑s′∈SPsa(s′)V(s′)
总结而言 ,对于步进中我们会基于过往的经验 Psa 选取在当下看来最优秀的策略,并且形成一套自己的策略进而选取在 si 下的操作 ai .
更新经验 Psa(s′)#
在步进了一段时间之后,我们需要对于过往的经验进行更新,将最近若干次的实验的结果给放进去,实际情况下,我们会让机器人使用当前的策略进行运动,记录下实际的数据,也就是** 将实验中的N(s,a,s’)作为数据来源,对于**
** Psa(s′) 进行更新**
数学表达为 Psa(s′)←∑s′′N(s,a,s′′)N(s,a,s′)
最后合起来,即有MDP(使用贪心策略进行动作选取(Bellman Equation))的基本步骤
- 首先随机初始化 π,V,Psa(s′) 并且设定好R
- 重复一下步骤
(1)使用 π 进行若干轮实验
(2)更新 Psa(s′)
(3)使用value iteration对于 V(s) 进行更新,进而更新我们的 π
以上是最为基本的MDP,他纯纯使用** 贪心算法,而且我们的操作是只有 离散**的情形。而在此基础上还可以进行一定的改进
Improved MDP#
MDP+Randomness#
考虑如下的一个场景:如果我们每一步会扣除点数-0.05
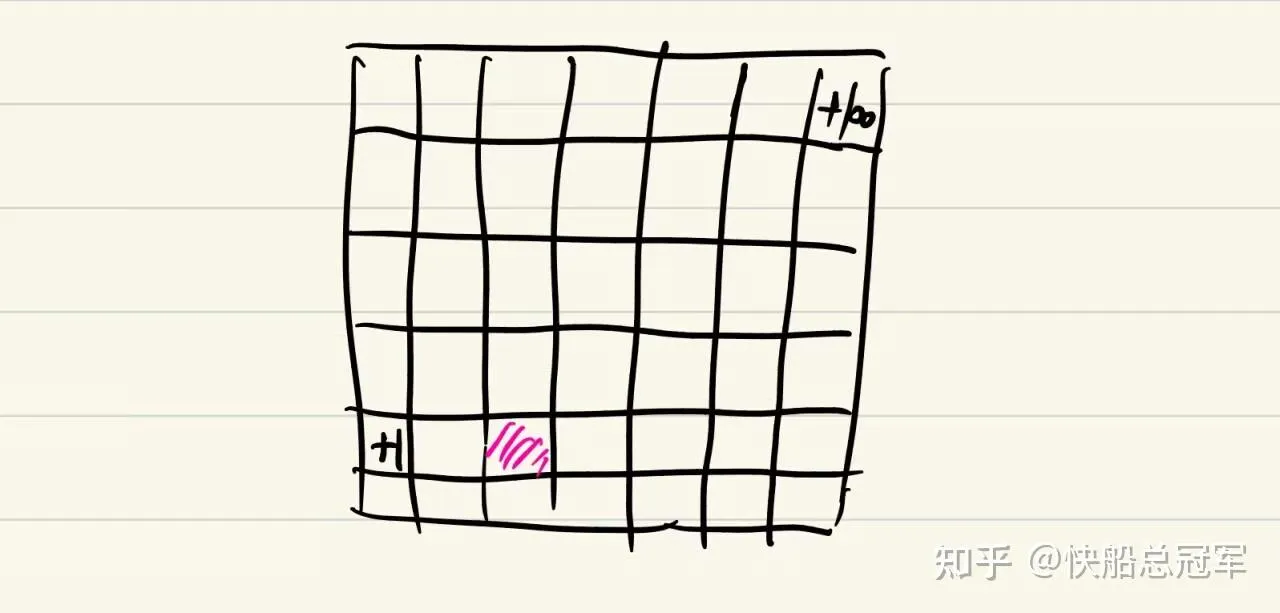
如果我们使用MDP的话,会直接通往+1的点,但是实际的话** 贪心并不是最优的策略**,于是我们对于动作的选取方案改变为: a=ηπ(s)+(1−η)arandomlychoosen
这样的话添加了一些** 随机性**,就可以有比较优良的结果了。
连续动作空间的MDP#
如果我们的状态空间为连续的,比如对于一个机器人的的位置与角度。而此时我们有若干解决方案
** Method 1:**
将我们的state的变量 (x1,x2,…xm) 所在的空间分割成若干个网格(离散化),然后使用之前的方法。
这样的好处是能训练完成之后机器人会有非常优秀的表现,坏处是离散化之后的state会非常的大,对于变量过多时不建议考虑
** Method 2:**
使用外部的物理引擎,这一块请咨询** userlzh** from ustcsgy
** Method 3:Fitted Value iteration**
我们之前对于策略的选取是通过value iteration将 Psa(s)⇒V(s)⇒π(s) ,而对于Bellman equation中我们无法取遍所有的a,于是对于 V(s) 就需要通过神经网络(如规定一系列的基函数 ϕ(s),V(s)=θTϕ(s) )去进行逼近,我们想要该案例去学习这些参数具体步骤为
- Step1: 随机选取m个状态 s1,s2,.....sm
- Step2: 重复一下步骤
(1)对于每一个i,计算在每一个动作a下面的损失 q(a)=k1∑j=1kR(s(i))+γV(sj′) (将q作为对于 V(si)
的一个样本)
(2) yi=maxaq(a) (得到 V∗(si) 的样本)
(3)使用 (si,yi) 去更新参数 θ:=argminθ21∑i=1m(θTϕ(s(i))−y(i))2
然后我们进行正常的MDP即可。
以上变为强化学习的最为基本 的内容,对于具体的代码实现(我们已经给出了伪代码)请参见github仓库,MDP(使用贪心进行策略选取,并以此优化策略)的方法还是非常的精妙的 ,更多的强化学习的内容之后我们会在cs236中进行学习。