听了后面的Lecture 5, 正好从更高的视角来观察之前学过的这些模型与算法。
对于机器学习的主要步骤为(1)希望对于待预测的输入x进行预测 (2)将x扔进一个假设(hypothesis) hθ(x) 中(3)函数会给出我们需要的预测 y^ ,而对于假设 hθ(x) 的求解是通过给一个Training sets, 通过某种学习算法,得出假设中所需要的参数值。
接下来我们将会基于以下假设来推导出线性回归的假设函数 hθ(x) 以及所需要的损失函数
- 假设响应y和输入x为线性关系,即为存在一组参数 θ∈Rn+1 使得 y=θTx ,我们认为 x0=1 ,代表常数项
- 对于实际的情况,由中心极限定理 我们知y和 hθ(x) 之间的差值 Δ 可以认为满足正态分布
- 对于训练过程中 θ 目标是使得 Δ 的最大似然估计最大
基于以上的假设,我们有
L(θ)=Πi=1mP(Δ)=Πi=1mP(yi∣xi,θ)=Πi=1m2πσ1exp(−2σ2(yi−θTxi)2) 目标是使得这个函数最大,即为让该函数的对数函数最大,左右取对数
MLE=l(θ)=log(Lθ)=Πi=1m2πσ1exp(−2σ2(yi−θTxi)2)=−mlog(2πσ)−2σ21Σi=1m(yi−θTxi)2 从而解释了为什么我们对于线性回归函数在别的教科书上会取 J(θ)=21Σi=1m(yi−θTxi)2 为损失函数,对于指数取2是因为正态分布可以推导出来这个东西,而目标是损失函数最小,这个自然符合“最大似然估计最大”。
以上都是对于线性回归,而对于逻辑回归,我们做的假设是
- hθ(x)=P(y∣x,θ),y=argmaxy(P(y∣x)),y∈{0,1}
- hθ(x)=sigmoid(x)=1+e−θTx1
同样是使用最大似然估计,这里我们有 P(yi∣xi,θ)=hθ(x)yi(1−hθ(x))1−yi 可以得到
MLE=l(θ)=Σi=1myilog(hθ(x))+(1−yi)log(1−hθ(x))
这个即为我们想要的损失函数
有了损失函数(through learning algorithm),我们如何通过损失函数求解出相对应的参数 θ ,最为常用的就是梯度下降,一般的模型而言,公式为
θ:=θ−α∂θ∂J(θ)
其中 α 我们一般称为是学习率,对于线性回归(Exponential family 中的正态分布),逻辑回归(Exponential family 中的伯努利分布),我们有Exponential family中的统一公式
θj:=θj+α(yi−hθ(xi))xi
在使用的时候,我们一般是用
θj:=θj+αm1Σi=1m(yi−hθ(xi))xi
以上是最为重要的东西,下面是一些辅助的特殊的算法(设计非常精妙,但是相当于数学中的奇技淫巧,不能说是开创性的,大纲性的内容。
- 随机梯度下降(stochastic gradient descent):
实际使用的过程中,由于正常的梯度下降的过程在每一个iteration中都需要将整个数据集给遍历一遍,现实中的数据集非常大,每次操作需要遍历一遍过于浪费时间了,因此我们考虑使用
θj:=θj+α(yi−hθ(xi))xi
i不断从1-m中来回遍历,而且对于学习率也随着时间不断下降,这样操作的坏处是可能结果不会收敛,精度会比较小,但是好处是节约内存。
2.Newton方法
Newton方法是一种快速逼近零点的方法(** 特别注意,最好取要逼近的函数上只有一个0点**)
Newton方法的操作见示意图
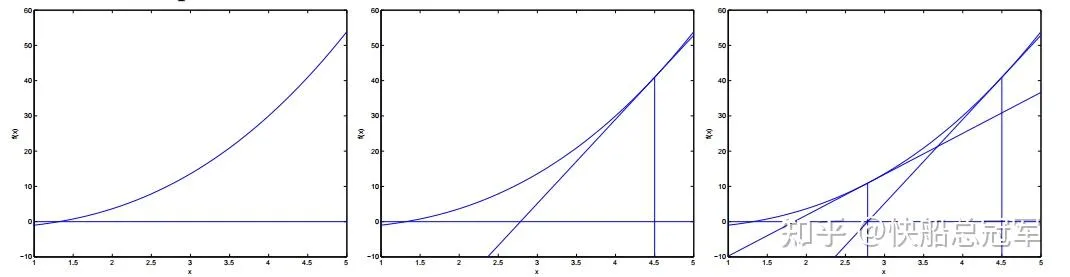
蓝色的曲线是 f(x) ,我们想要找到f(x)=0的解,对于最一开始随便找的点 x0 可以使用牛顿法找到 x1 ,依次找下去,最后会收敛到零点。用数学去表示即为 θ:=θ−f′(θ)f(θ)
由于我们在求解机器学习中的参数 θ 的时候,是使用 J′(θ)=0 去求解的,因此有
θ:=θ−J′′(θ)J′(θ) ,一般的形式为 θ:=θ−H−1∇θJ(θ) ,其中 H=∂θi∂θj∂2J(θ)
- 使用Newton方法的优点是它非常的快,因为它是二次收敛的(收敛的速度是梯度下降的平方倍),因此对于参数大小比较小的时候(10-100)的时候还是比较好的。
- 虽然但是由于这里面涉及到了求解矩阵的逆的过程,同时由于求逆,还要保证Hessian矩阵的行列式不可以为0,因此还是要慎重使用(参考Problem 1)
3.LWR(Locally Weighted Regression)
对于之前的求解过程中,我们在训练的时候对于每一个训练数据的权重都是相同的,实际上我们希望偏重于我们目标位置处的点,因此我们使用Locally Weighted Regression,即为添加一些权重项,很自然的我们想要使用正态分布来考虑。
即为 J(θ)=Σi=1mwi(yi−θTxi)2 ,其中 wi=exp(−2τ2(xi−x)2)
在训练的过程中,对于给定的xi,我们计算这个点的J,结合该点的权重,拟合出来响应点x的参数,最后得到输出。