CS230 C2W1&2:模型训练常见trick——正则化方法&梯度调整方法
CS230 C2W1&2:模型训练常见trick——正则化方法&梯度调整方法
上一章中我们实现了任意大小的神经网络,但是当我们使用非常深的神经网络去进行预测时,会发现在测试集上的表现非常差劲,同时也会对于梯度报一些奇怪的错误。
这说明我们的深度神经网络非常容易发生过拟合 的问题,并且容易容易发生梯度爆炸以及梯度消失 的问题。针对前者,我们可以使用正则化,dropout 的方法来减小这个问题,而对于后者,我们首先需要进行梯度的检测,对于梯度爆炸以及消失的话我们需要对于使用一些梯度调整方法
正则化方法#
对于正则化而言,常见的方法是** 参数正则化以及 dropout**方法
参数正则化#
参数正则化,就是对于将** 参数的大小也作为惩罚项**,假设原本的损失函数为 ,则 ,如果参数的范数过大,损失函数也会就范数这个方向进行调整。从而减小整体的范数的大小,最后达到减小过拟合趋势这个目的。
正则化的损失函数实现
def compute_cost_with_regularization(A3, Y, parameters, lambd):
    """
    Arguments:
    A3 -- post-activation, output of forward propagation, of shape (output size, number of examples)
    Y -- "true" labels vector, of shape (output size, number of examples)
    parameters -- python dictionary containing parameters of the model

    Returns:
    cost - value of the regularized loss function (formula (2))
    """
    m = Y.shape[1]
    W1 = parameters["W1"]
    W2 = parameters["W2"]
    W3 = parameters["W3"]

    cross_entropy_cost = compute_cost(A3, Y)
    cross_entropy_cost+= (lambd/(2*m))*(np.sum(np.square(W1))+np.sum(np.square(W2))+np.sum(np.square(W3)))
return cross_entropy_cost对于参数正则化时,反向传播时对于参数项需要加上 这一项
def backward_propagation_with_regularization(X, Y, cache, lambd):
    """
    Implements the backward propagation of our baseline model to which we added an L2 regularization.

    Arguments:
    X -- input dataset, of shape (input size, number of examples)
    Y -- "true" labels vector, of shape (output size, number of examples)
    cache -- cache output from forward_propagation()
    lambd -- regularization hyperparameter, scalar

    Returns:
    gradients -- A dictionary with the gradients with respect to each parameter, activation and pre-activation variables
    """
    m = X.shape[1]
    (Z1, A1, W1, b1, Z2, A2, W2, b2, Z3, A3, W3, b3) = cache

    dZ3 = A3 - Y
    dW3=  1./m *np.dot(dZ3,A2.T)+(lambd/m)*W3
    db3 = 1./m * np.sum(dZ3, axis=1, keepdims = True)

    dA2 = np.dot(W3.T, dZ3)
    dZ2 = np.multiply(dA2, np.int64(A2 > 0))
    dW2= 1./m * np.dot(dZ2,A1.T) +(lambd/m) *W2
    db2 = 1./m * np.sum(dZ2, axis=1, keepdims = True)

    dA1 = np.dot(W2.T, dZ2)
    dZ1 = np.multiply(dA1, np.int64(A1 > 0))
    dW1=1./m *np.dot(dZ1,X.T) +(lambd/m)*W1
    db1 = 1./m * np.sum(dZ1, axis=1, keepdims = True)

    gradients = {"dZ3": dZ3, "dW3": dW3, "db3": db3,"dA2": dA2,
                 "dZ2": dZ2, "dW2": dW2, "db2": db2, "dA1": dA1,
                 "dZ1": dZ1, "dW1": dW1, "db1": db1}

return gradients我们将其用于一个二分类的系统,
parameters = model(train_X, train_Y)
print ("On the training set:")
predictions_train = predict(train_X, train_Y, parameters)
print ("On the test set:")
predictions_test = predict(test_X, test_Y, parameters)设置超参数 则结果为
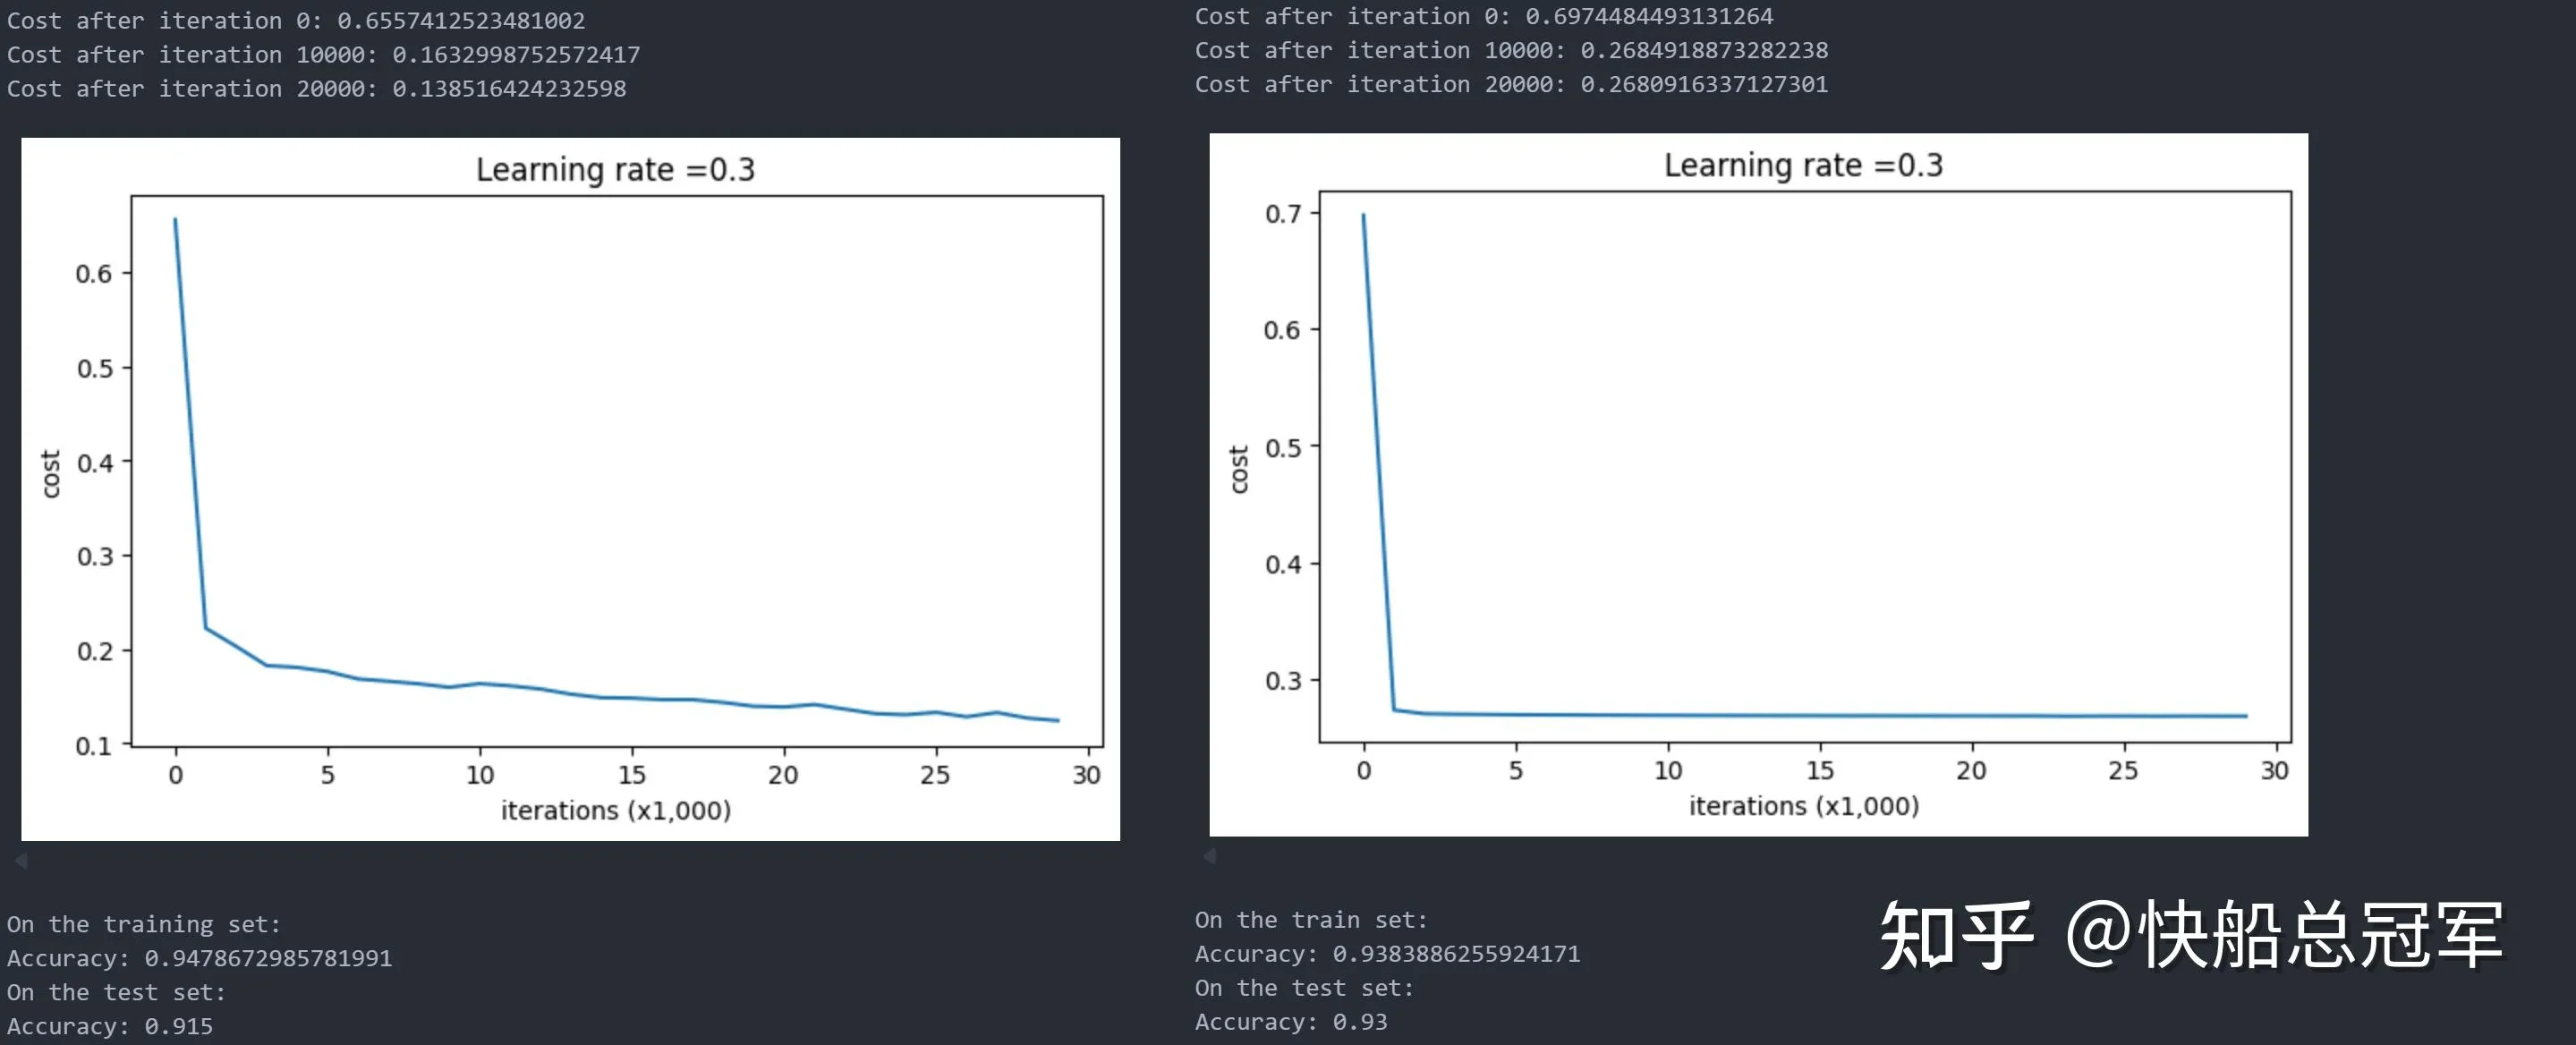
lambda=0,0.7
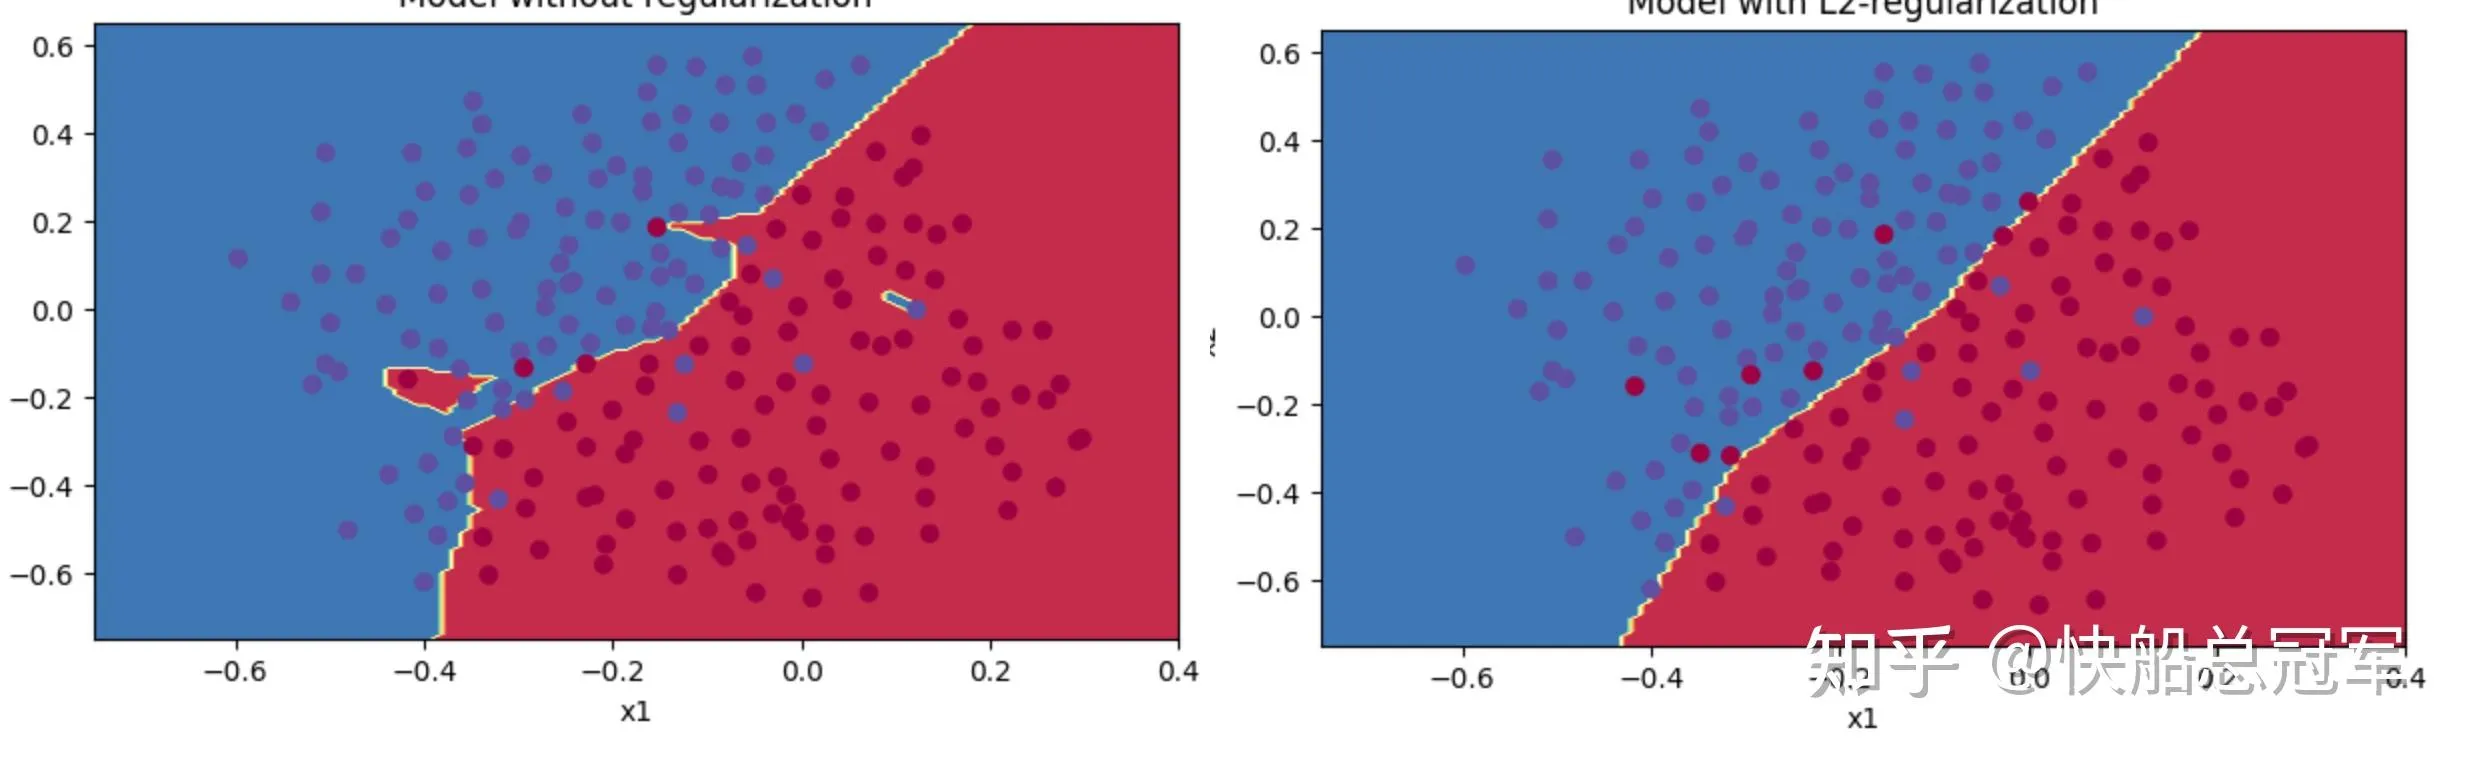
如果绘制出来分类结果为
dropout方法#
what is dropout
dropout,故名思意,就是对于每一个iteration内以一定的比例去删除其中的某些连接关系,然后进行正向传播以及反向传播并更新参数,对于每一个iteration都是如此,从而到了最后每一个节点。
为什么dropout会减少过拟合?因为我们知道神经网络是学习输入的特征的,过拟合表示有的神经元会学到一些噪声数据,然后进行加强了,而dropout则是通过减少这些神经元被迭代的次数,从而减少神经网络学习噪声数据的影响。当然dropout也会有一定的缺点,会导致欠拟合以及重要的信息的丢失,所以使用频率不如正则化参数。
** how to conduct dropout?**
我们会对于每一次iteration执行之前,添加一个mask层,对于这个mask层是一个对应元素连接的,全部参数为True或False的层。如果为True,则会继续传递,反之会传递参数0。用图形表示即为
同时由于我们设置每一个点dropout的概率为keep_prob,为了保证整体的均值不变,对于每一层生成的数据要** 除keep_prob**来保证均值不变。
因此对于每一个iteration中,我们会** 随机生成每一层的mask**, 然后将mask层添加到正向传播以及反向传播中。
def forward_propagation_with_dropout(X, parameters, keep_prob = 0.5):
    np.random.seed(1)

    # retrieve parameters
    W1 = parameters["W1"]
    b1 = parameters["b1"]
    W2 = parameters["W2"]
    b2 = parameters["b2"]
    W3 = parameters["W3"]
    b3 = parameters["b3"]

    # LINEAR -> RELU -> LINEAR -> RELU -> LINEAR -> SIGMOID
    Z1 = np.dot(W1, X) + b1
    A1 = relu(Z1)
    # add mask
    D1=np.random.rand(A1.shape[0],A1.shape[1])
    D1=(D1<keep_prob).astype(int)
    # apply mask
    A1=A1*D1
    A1=A1/(keep_prob)

    Z2 = np.dot(W2, A1) + b2
    A2 = relu(Z2)
    D2 = np.random.rand(A2.shape[0],A2.shape[1])
    D2 = (D2 < keep_prob).astype(int)
    A2 = A2 * D2
    A2 = A2 / keep_prob

    Z3 = np.dot(W3, A2) + b3
    A3 = sigmoid(Z3)

    cache = (Z1, D1, A1, W1, b1, Z2, D2, A2, W2, b2, Z3, A3, W3, b3)

return A3, cache而反向传播同理,也要注意均值的处理
def backward_propagation_with_dropout(X, Y, cache, keep_prob):


    m = X.shape[1]
    (Z1, D1, A1, W1, b1, Z2, D2, A2, W2, b2, Z3, A3, W3, b3) = cache

    dZ3 = A3 - Y
    dW3 = 1./m * np.dot(dZ3, A2.T)
    db3 = 1./m * np.sum(dZ3, axis=1, keepdims = True)
    dA2 = np.dot(W3.T, dZ3)
    ### START CODE HERE ### (≈ 2 lines of code)
    dA2=dA2*D2
    dA2=dA2/(keep_prob)
    ### END CODE HERE ###
    dZ2 = np.multiply(dA2, np.int64(A2 > 0))
    dW2 = 1./m * np.dot(dZ2, A1.T)
    db2 = 1./m * np.sum(dZ2, axis=1, keepdims = True)

    dA1 = np.dot(W2.T, dZ2)
    dA1=dA1*D1
    dA1=dA1/(keep_prob)

    dZ1 = np.multiply(dA1, np.int64(A1 > 0))
    dW1 = 1./m * np.dot(dZ1, X.T)
    db1 = 1./m * np.sum(dZ1, axis=1, keepdims = True)

    gradients = {"dZ3": dZ3, "dW3": dW3, "db3": db3,"dA2": dA2,
                 "dZ2": dZ2, "dW2": dW2, "db2": db2, "dA1": dA1,
                 "dZ1": dZ1, "dW1": dW1, "db1": db1}

return gradients最后我们的结果为
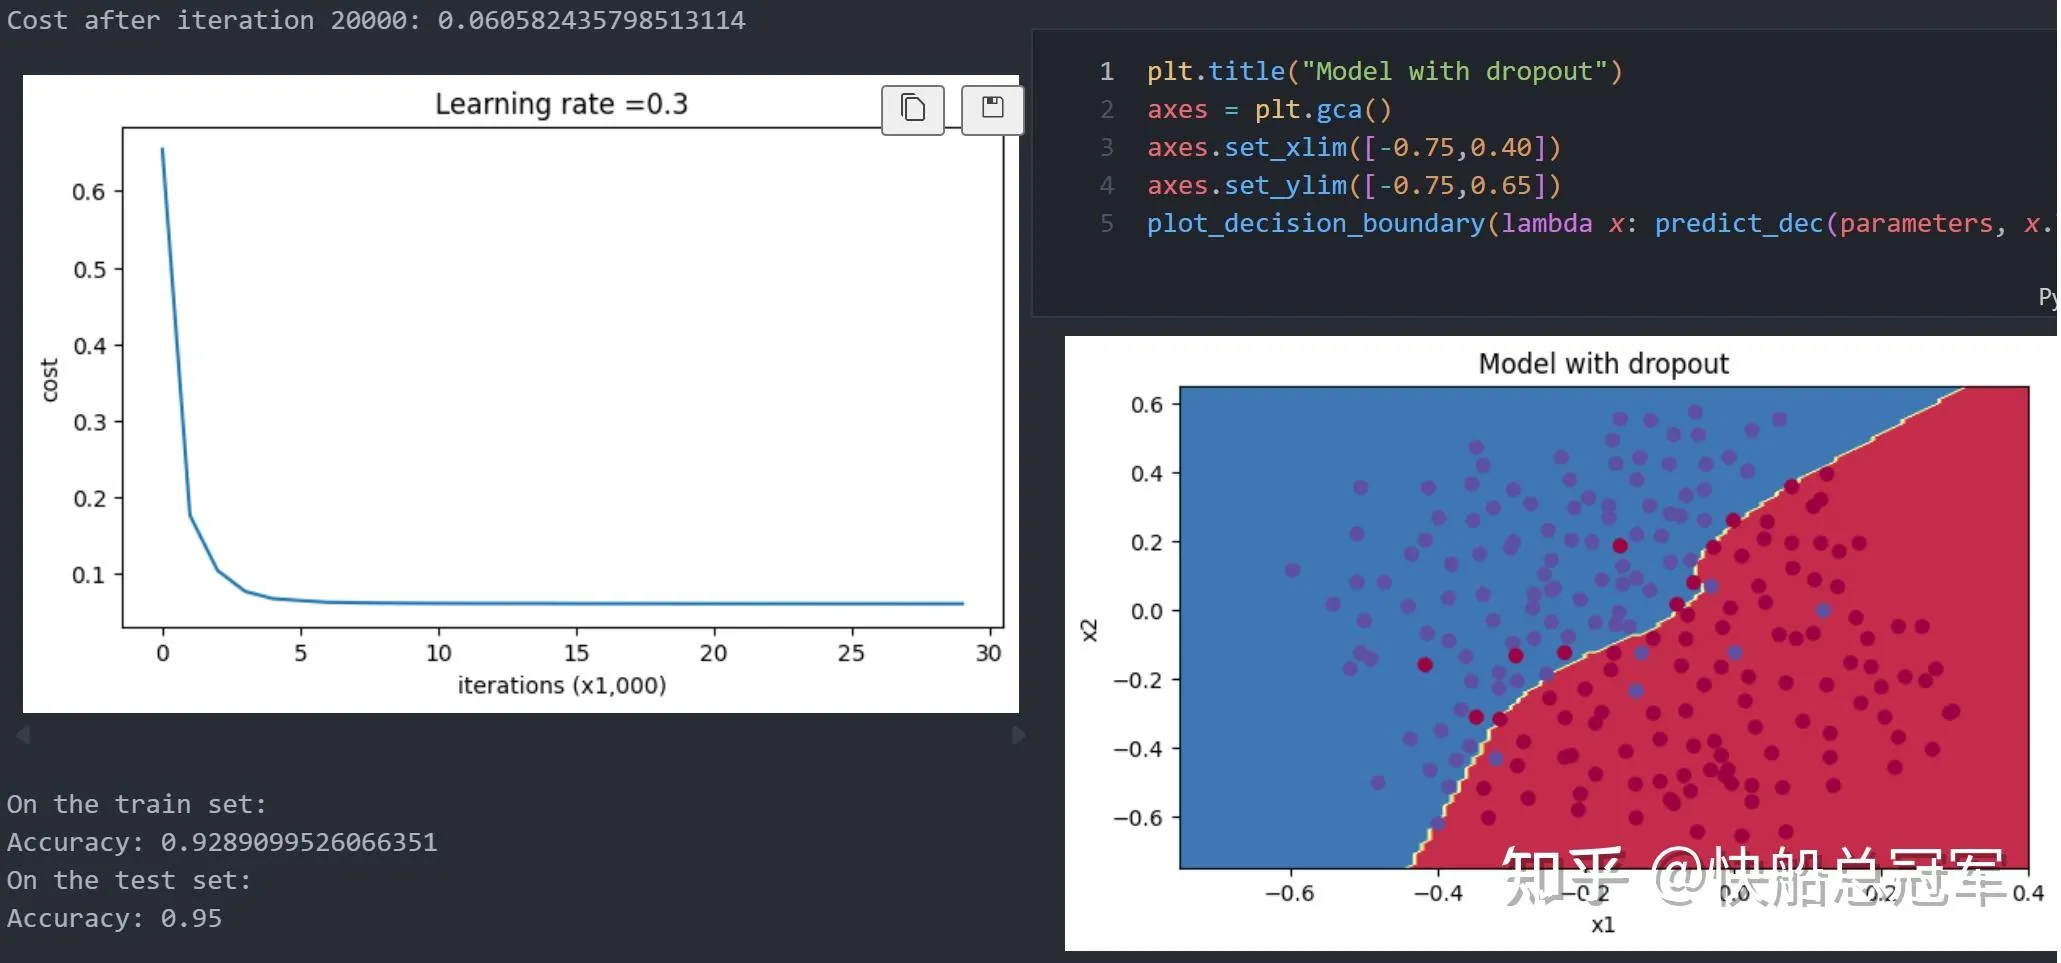
可以发现,对于添加正则项以及dropout确实可以减少过拟合的趋势
其余常见的正则化方法:#
实际使用的时候还有一些常见的方法。
其一是early ending,就是等到训练到中途,这个时候模型在测试数据集上的表现最好的时候提前结束
其二是** 增加数据量**,尤其是在CV中,可以对于一张图片,选取其中几个小部分作为新的数据,也可以做旋转,翻转,颜色上做一些处理,反正就就是** 想尽办法增加数据量**
其三是** 模型融合**,这个在cs229的笔记中有详细的介绍
梯度调整方法#
在训练的时候由于在传播的途径中会有大量的东西进行相乘,这可能会导致当传播到深层次的网络时,梯度爆炸/消失。为了避免这个问题,我们会采取几种策略来应对它。
梯度检测方法#
梯度检测方法可以有效的检验我们训练出的模型有没有发生梯度消失/爆炸的方法。它是通过定义计算梯度来验证反向传播中梯度计算是否有问题。
具体方法:假设我们要考察 的梯度
- 使用 grad_{true}=\dfrac{\partial J}{\partial \theta} = \lim_{\varepsilon \to 0} \dfrac{J(\theta + \varepsilon) - J(\theta - \varepsilon)}{2 \varepsilon} \tag{1}
,即为设参数 并进行正向传播,计算最后的损失函数,这样计算得到的梯度是精确的 - 使用反向传播计算出
- 计算整体差值于整体的比例 difference = \dfrac {\mid\mid grad - gradapprox \mid\mid_2}{\mid\mid grad \mid\mid_2 + \mid\mid gradapprox \mid\mid_2} \tag{2}
- 若difference>k,那么可以认为整体式梯度出现了问题
具体代码实现
def gradient_check_n(parameters, gradients, X, Y, epsilon = 1e-7):
    # Set-up variables
    parameters_values, _ = dictionary_to_vector(parameters)
    grad = gradients_to_vector(gradients)
    num_parameters = parameters_values.shape[0]
    J_plus = np.zeros((num_parameters, 1))
    J_minus = np.zeros((num_parameters, 1))
    gradapprox = np.zeros((num_parameters, 1))

    # Compute gradapprox
    for i in range(num_parameters):

        # Compute J_plus[i]. Inputs: "parameters_values, epsilon". Output = "J_plus[i]".
        # "_" is used because the function you have to outputs two parameters but we only care about the first one
        parameters_value=np.copy(parameters_values)
        parameters_value[i]+=epsilon
        J_plus[i],_=forward_propagation_n(X,Y,vector_to_dictionary(parameters_value))
        # Compute J_minus[i]. Inputs: "parameters_values, epsilon". Output = "J_minus[i]".
        parameters_value=np.copy(parameters_values)
        parameters_value[i]-=epsilon
        J_minus[i],_=forward_propagation_n(X,Y,vector_to_dictionary(parameters_value))

        # Compute gradapprox[i]
        gradapprox[i]=(J_plus[i]-J_minus[i])/(2*epsilon)

    # Compare gradapprox to backward propagation gradients by computing difference.
    print(grad)
    difference=(np.linalg.norm(gradapprox-grad,ord=2))/(np.linalg.norm(gradapprox,ord=2)+np.linalg.norm(grad,ord=2))
    if difference > 2e-7:
        print ("\033[93m" + "There is a mistake in the backward propagation! difference = " + str(difference) + "\033[0m")
    else:
        print ("\033[92m" + "Your backward propagation works perfectly fine! difference = " + str(difference) + "\033[0m")
return differencegradient checking可以有效的检验梯度是否有问题,但是我们由于每一次check时间复杂度非常高 ,因此不会每一次都去计算。实际应用的时候可以没隔开几次检查一下。
初始化方法#
初始化是解决梯度爆炸的一种方法,初始化的不同位置可以调整我们每一次对梯度修改的幅度,从而避免一大堆的>1的数字乘在一起,导致梯度爆炸。
于此同时,由于我们希望不同的神经元可以学习到不同的特征以及信息,而不是全部学习某一种特征,因此我们需要添加一些随机性,使得不同方向的特征都可以被学习到。
需要初始化的参数:
- the weight matrices
- the bias vectors
对于bias而言,我们是一般是初始化为0,避免发生避免发生偏置现象。即为
parameters['b'+str(l)]=np.zeros((layers_dims[l],1))由于ReLU函数是最为常见的损失函数,它会过滤调负数的数据,因此结合我们一般都是使用正态分布来初始化,因此我们只要对于Weight设置合理的方差即可。
parameters['W'+str(l)]=np.random.randn((layers_dims[l],layers_dims[l-1]))*sigma只要设计 的值就可以
- 错误的案例:0初始化
- 标准正态分布
- He 初始化 :我们希望 中z的方差不要跟着层数的增长而增长,由概率论知 有 。考虑到反向传播的因素,有
从而有 ,即为He initialization,He初始化对于ReLU 函数的网络效果特别好
分别使用以上几种方法初始化的分类结果为
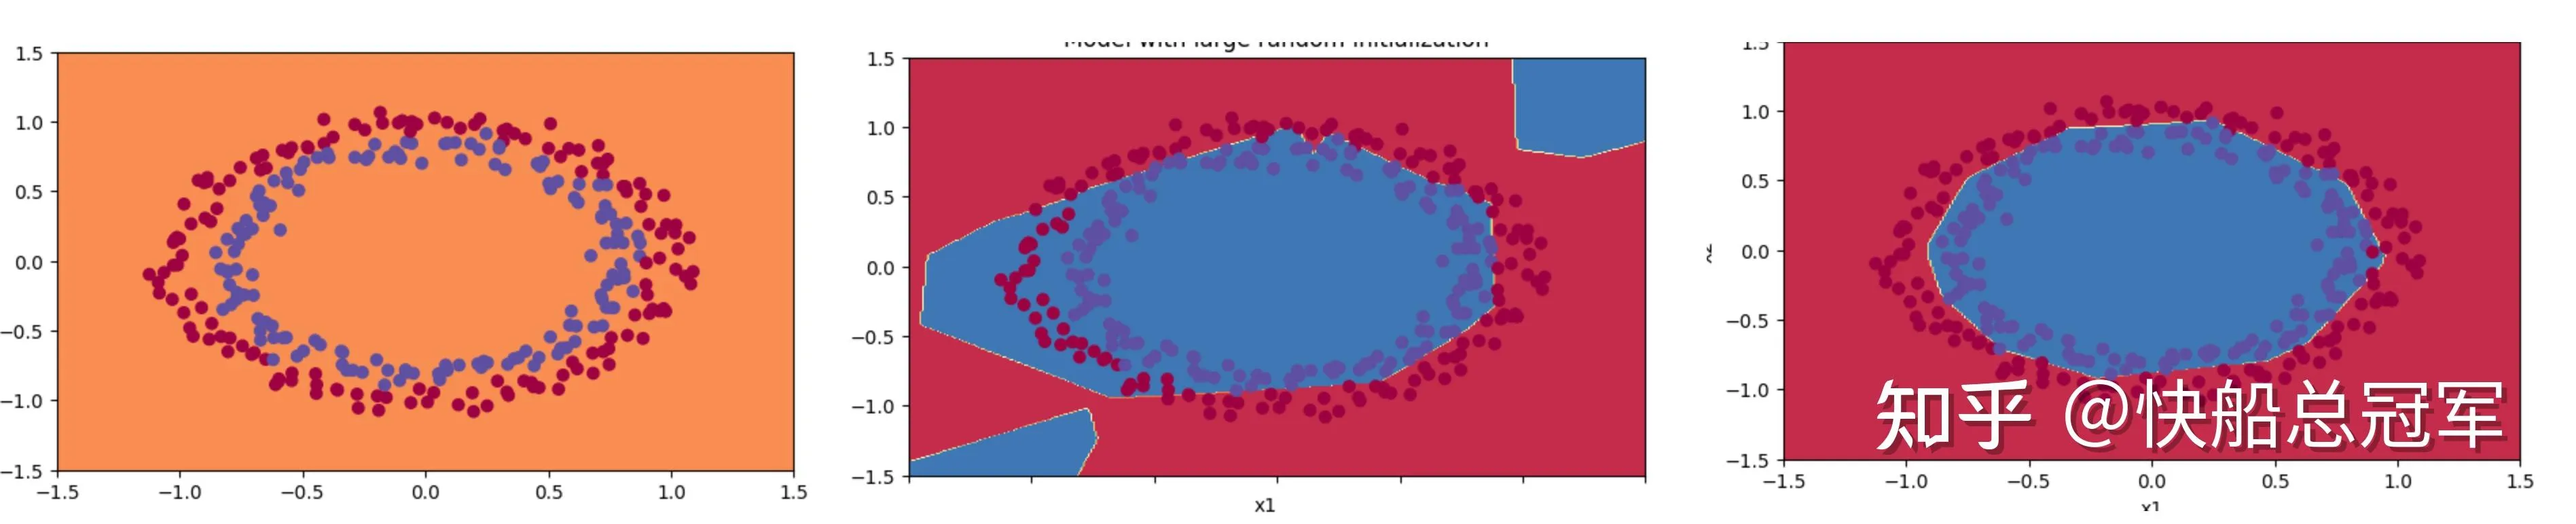
zeros, randn, He initialization
批量归一化(batch normalization)#
通过初始化来减小梯度爆炸/消失是一种手段,但是我们还可以通过直接规定某一层的输入的均值以及方差来进行初始化。
批量归一化,是建立在批量(输入X中的m的大小)输入的基础上进行。
训练的时候 步骤为
- 归一化:对于某一层 之前, 先计算个batch的输入的均值以及方差
,然后归一化 。通过这个步骤使得输入x均值为0,方差为1
- 建立可学习参数:对于传输到这一层真正的参数x,需要建立可以学习的东西,考虑可学习参数
,将这个 作为下一层的输入。
而对于预测 的时候,对于每一层的 我们直接使用训练的时候得到的数据进行预测。可以发现,我们对于b参数直接平移到了 参数上了。
batch normalization可以有效控制整体的梯度在1左右的范围,同时可以提升整体的鲁棒性,但是缺点是batch要求比较大,需要更大的批次来提升归一化的性能。批量归一化是对于深度神经网络非常重要的一种方法。
以上我们介绍了在进行模型训练的时候对于过拟合以及欠拟合常见的两个trick,但是这些都只能算是trick,真正重要的还是我们的超参数的设置。而为了学习更深的神经网络,就需要使用一些特殊的优化方法,这些将会在接下来的文章中讨论