为了学习更深的神经网络,我们需要更多的数据以及更深的神经网络,而把训练数据一次性输入大量占用内存 ,显然不是特别好的解决方案。因此我们接下来将会介绍mini-batch training,同时我们会介绍如何** 更加快速的训练**,即选择更加高效的优化算法。
mini-batch training#
之前我们的输入是 (batch training)每一个iteration将所有的东西输入进去,而于此同时我们也可以一个一个的输入,即为每一个iteration只输入一个 (stochastic gradient descent随机梯度下降)。
对于前者,一方面如果n非常的大,在每一次正向传播以及反向传播所需要的时间就非常的长,** 时间成本过大**。对于后者,由于单个数据之间的方差过大,会导致参数一直在最低点附近徘徊,** 总体效果非常差**。
因此我们使用一种介于中间的方法:** Mini-batch training**
我们不会将所有的训练数据一股脑输入,而是分割成batch=256/128/…的块。
数学上即有 ,其中
(对于最后一个batch取余数,在分割数据集之前先将所有的数据打乱),这样划分之后每一个 称为一个mini-batch
在每一个iteration中我们输入一个mini-batch,将整体循环几个epoch,得到最终的结果
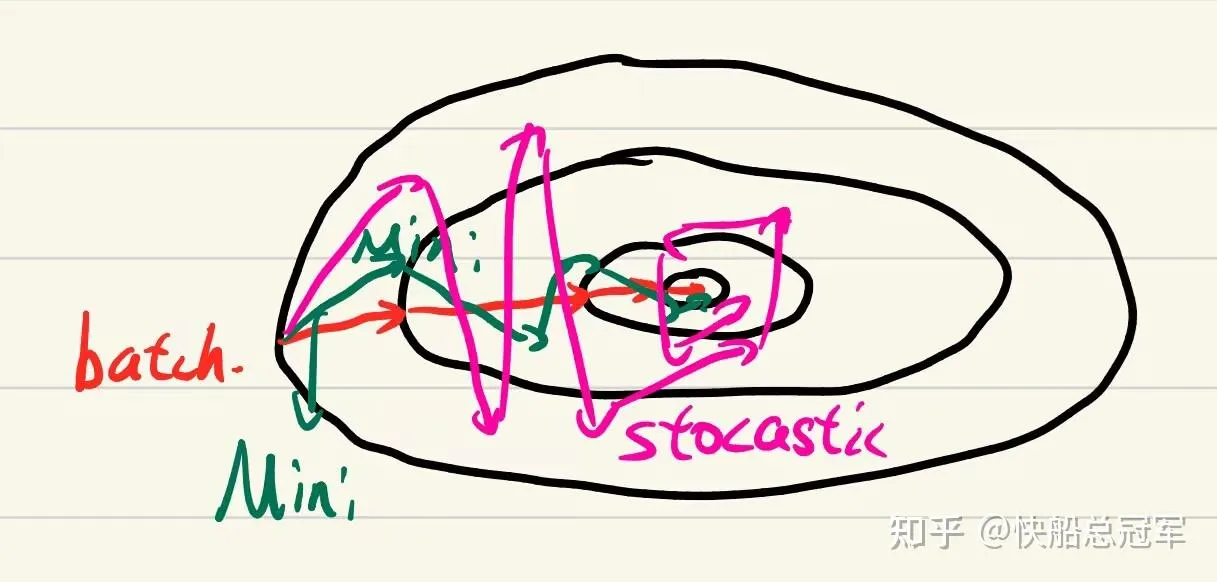
mini-batch相比于batch training中,iteration之间不一定会使得Loss下降,但是由于mini-batch的作用,他在整体方差上会比随机梯度下降小的多,在执行了更多个iteration之后,仍然会收敛到最后的结果。
从Contour图上看,收敛的情况
而在loss曲线上,则是
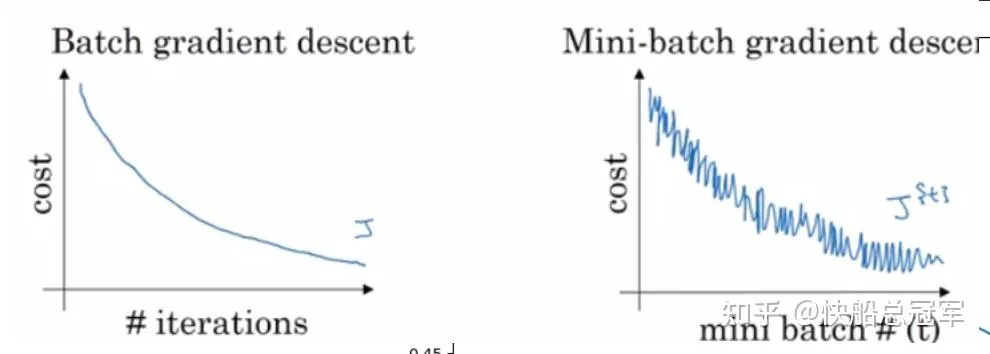
因此,mini-batch training会在除了batch normalization 中的性能有所影响,一般而言,Loss曲线都会以一个振荡的形式沿着batch training的曲线下降。今后的训练我们一般都会使用mini-batch training
于此同时,对于mini-batch training中的batch的值一般取2的指数幂 ,64,128,256之类的。
优化方法#
之前我们更新参数都是使用梯度下降 (沿着当前梯度最大的方向下降),相当于在参数空间上沿着山脊下降到山谷,但是如果想如图的画面时,就会画相对较长的时间。
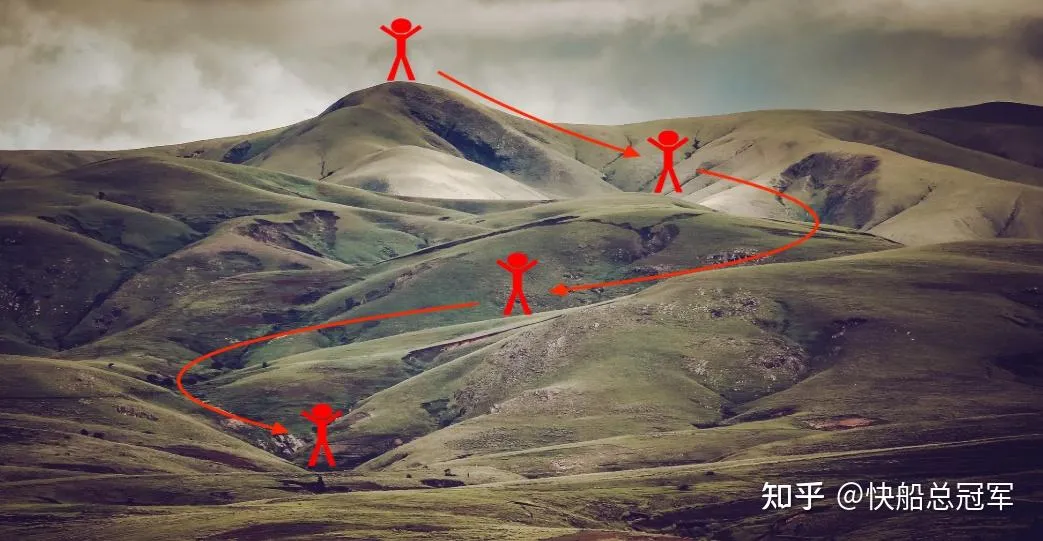
从contour图的角度去看,就是在某些方向上我们的loss曲线振荡较为厉害,但是却没有向山谷前进更多的距离
如图中,我们希望在y轴方向上减小变化的速率 (让数据变化更加平稳,避免梯度爆炸),同时我们希望可以加快在x轴上移动的速率 (加快收敛的速率),针对这两者我们分别使用Momentum以及RMSprop 来解决,最后结合这两种优化方法的优点可以研究出Adam 优化方法。
Momentum(动量法)#
动量在Physics中是指物体可以保持原有的物体的运动属性的衡量标准,而我们想要通过动量加快在x轴收敛速度,可以使用Momentum(动量法)
为我们的梯度下降,对于此时的每一次的参数变化速率 并没有考虑到过去的情况。
为了保持原有的运动属性,我们将之前的变化趋势也要考虑进去,具体为
我们将 看成了Loss曲线的下降的加速度,加入了 来记录物体的速度,从而可以保持过往的变化趋势,进而考虑考虑到加速度里面,加快收敛速率
从contour图上来看就是
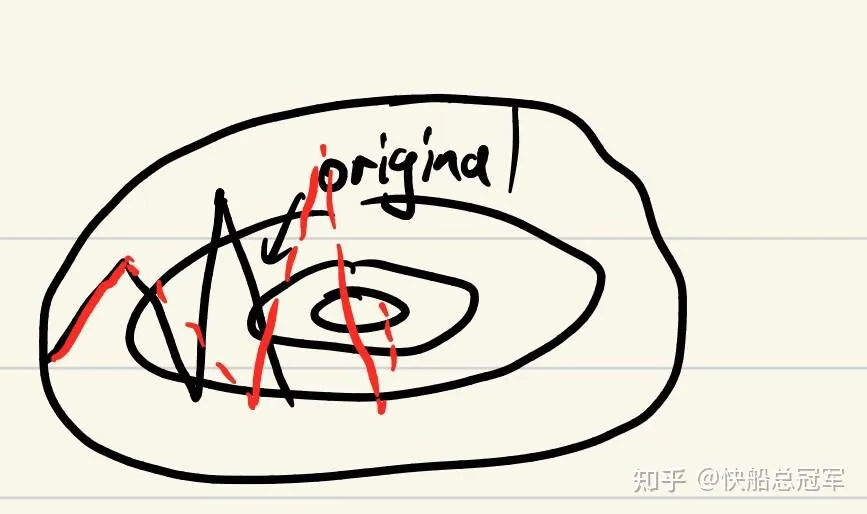
代码实现如下
def update_parameters_with_momentum(parameters, grads, v, beta, learning_rate):
    # in this function, we use gamma as the rate of change of the velocity

    L = len(parameters) // 2 # number of layers in the neural networks

    # Momentum update for each parameter
    for l in range(L):
        # update the velocity
        v['dW'+str(l+1)]=beta*v['dW'+str(l+1)]+(1-beta)*grads['dW'+str(l+1)]
        v['db'+str(l+1)]=beta*v['db'+str(l+1)]+(1-beta)*grads['db'+str(l+1)]
        # update the 'x' in the space
        parameters['W'+str(l+1)]-=learning_rate*v['dW'+str(l+1)]
        parameters['b'+str(l+1)]-=learning_rate*v['db'+str(l+1)]

return parameters, vRMSprop#
Momentum是使用动量来减少在y轴上的变化速率,而RMSprop则是通过计算通过惩罚的机制来惩罚那些变化过快的地方,奖赏那些变化比较快的地方,惩罚振荡过大的地方(RMSprop主要是针对y轴)
RMSprop的数学表达式
其中 为记录了过往的总的运动的路程的范数,从而在更新的时候,如果我们在y轴上振荡过快,就会有总的路程较大,我们也会做出较大的惩罚。对于x轴上,最一开始如果变化教慢, 使得v比较小,进而加快 在x轴上的变化速率
为了避免在更新的时候分母上有0 的出现,我们会加上一个 来避免inf的出现
图形化表示就是
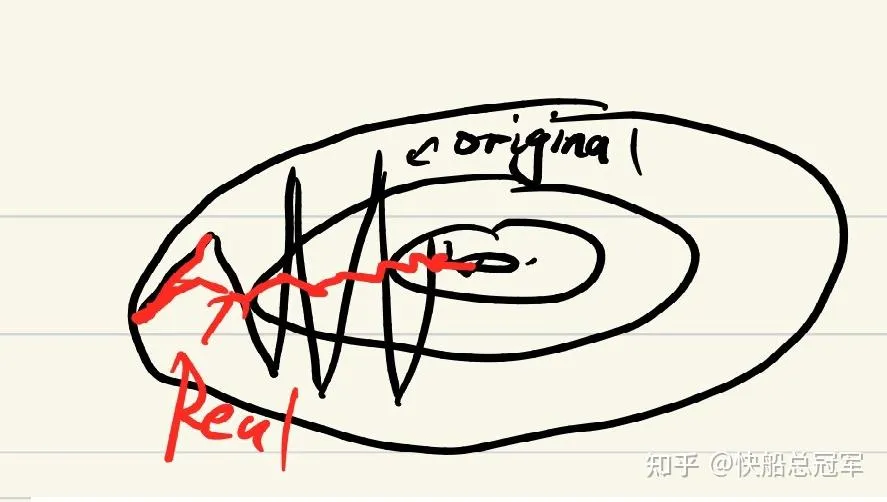
Adam#
Momentum,RMSprop一个加速,一个减速,我们同时考虑记录总的路程以及速度,而我们对于过往状态的考虑也不需要考虑过长时间的状态,需要添加一个收敛项 (有点类似于cs229中的Locally Weight Linear Model)最后得到Adam的更新公式
其中W为参数,对于速度以及路程,在运行之前先全部归0。
def update_parameters_with_adam(parameters, grads, v, s, t, learning_rate = 0.01,
                                beta1 = 0.9, beta2 = 0.999,  epsilon = 1e-8):

    L = len(parameters) // 2                 # number of layers in the neural networks
    v_corrected = {}                         # Initializing first moment estimate, python dictionary
    s_corrected = {}                         # Initializing second moment estimate, python dictionary

    # Perform Adam update on all parameters
    for l in range(L):
        # Moving average of the gradients. Inputs: "v, grads, beta1". Output: "v".
        v['dW'+str(l+1)]=beta1*v['dW'+str(l+1)]+(1-beta1)*(grads['dW'+str(l+1)])
        v['db'+str(l+1)]=beta1*v['db'+str(l+1)]+(1-beta1)*(grads['db'+str(l+1)])

        # Compute bias-corrected first moment estimate. Inputs: "v, beta1, t". Output: "v_corrected".
        v_corrected['dW'+str(l+1)]=v['dW'+str(l+1)]/(1-np.power(beta1,t))
        v_corrected['db'+str(l+1)]=v['db'+str(l+1)]/(1-np.power(beta1,t))

        # Moving average of the squared gradients. Inputs: "s, grads, beta2". Output: "s".
        s['dW'+str(l+1)]=beta2*s['dW'+str(l+1)]+(1-beta2)*(np.power(grads['dW'+str(l+1)],2))
        s['db'+str(l+1)]=beta2*s['db'+str(l+1)]+(1-beta2)*(np.power(grads['db'+str(l+1)],2))

        # Compute bias-corrected second raw moment estimate. Inputs: "s, beta2, t". Output: "s_corrected".
        s_corrected['dW'+str(l+1)]=s['dW'+str(l+1)]/(1-np.power(beta2,t))
        s_corrected['db'+str(l+1)]=s['db'+str(l+1)]/(1-np.power(beta2,t))
        # Update parameters. Inputs: "parameters, learning_rate, v_corrected, s_corrected, epsilon". Output: "parameters".
        parameters['W'+str(l+1)]-=learning_rate*v_corrected['dW'+str(l+1)]/(np.sqrt(s_corrected['dW'+str(l+1)])+epsilon)
        parameters['b'+str(l+1)]-=learning_rate*v_corrected['db'+str(l+1)]/(np.sqrt(s_corrected['db'+str(l+1)])+epsilon)
return parameters, v, s同时对于一个二分类问题使用以上的过去的Gradient Descent以及Adam Optimizer,Loss以及结果如图
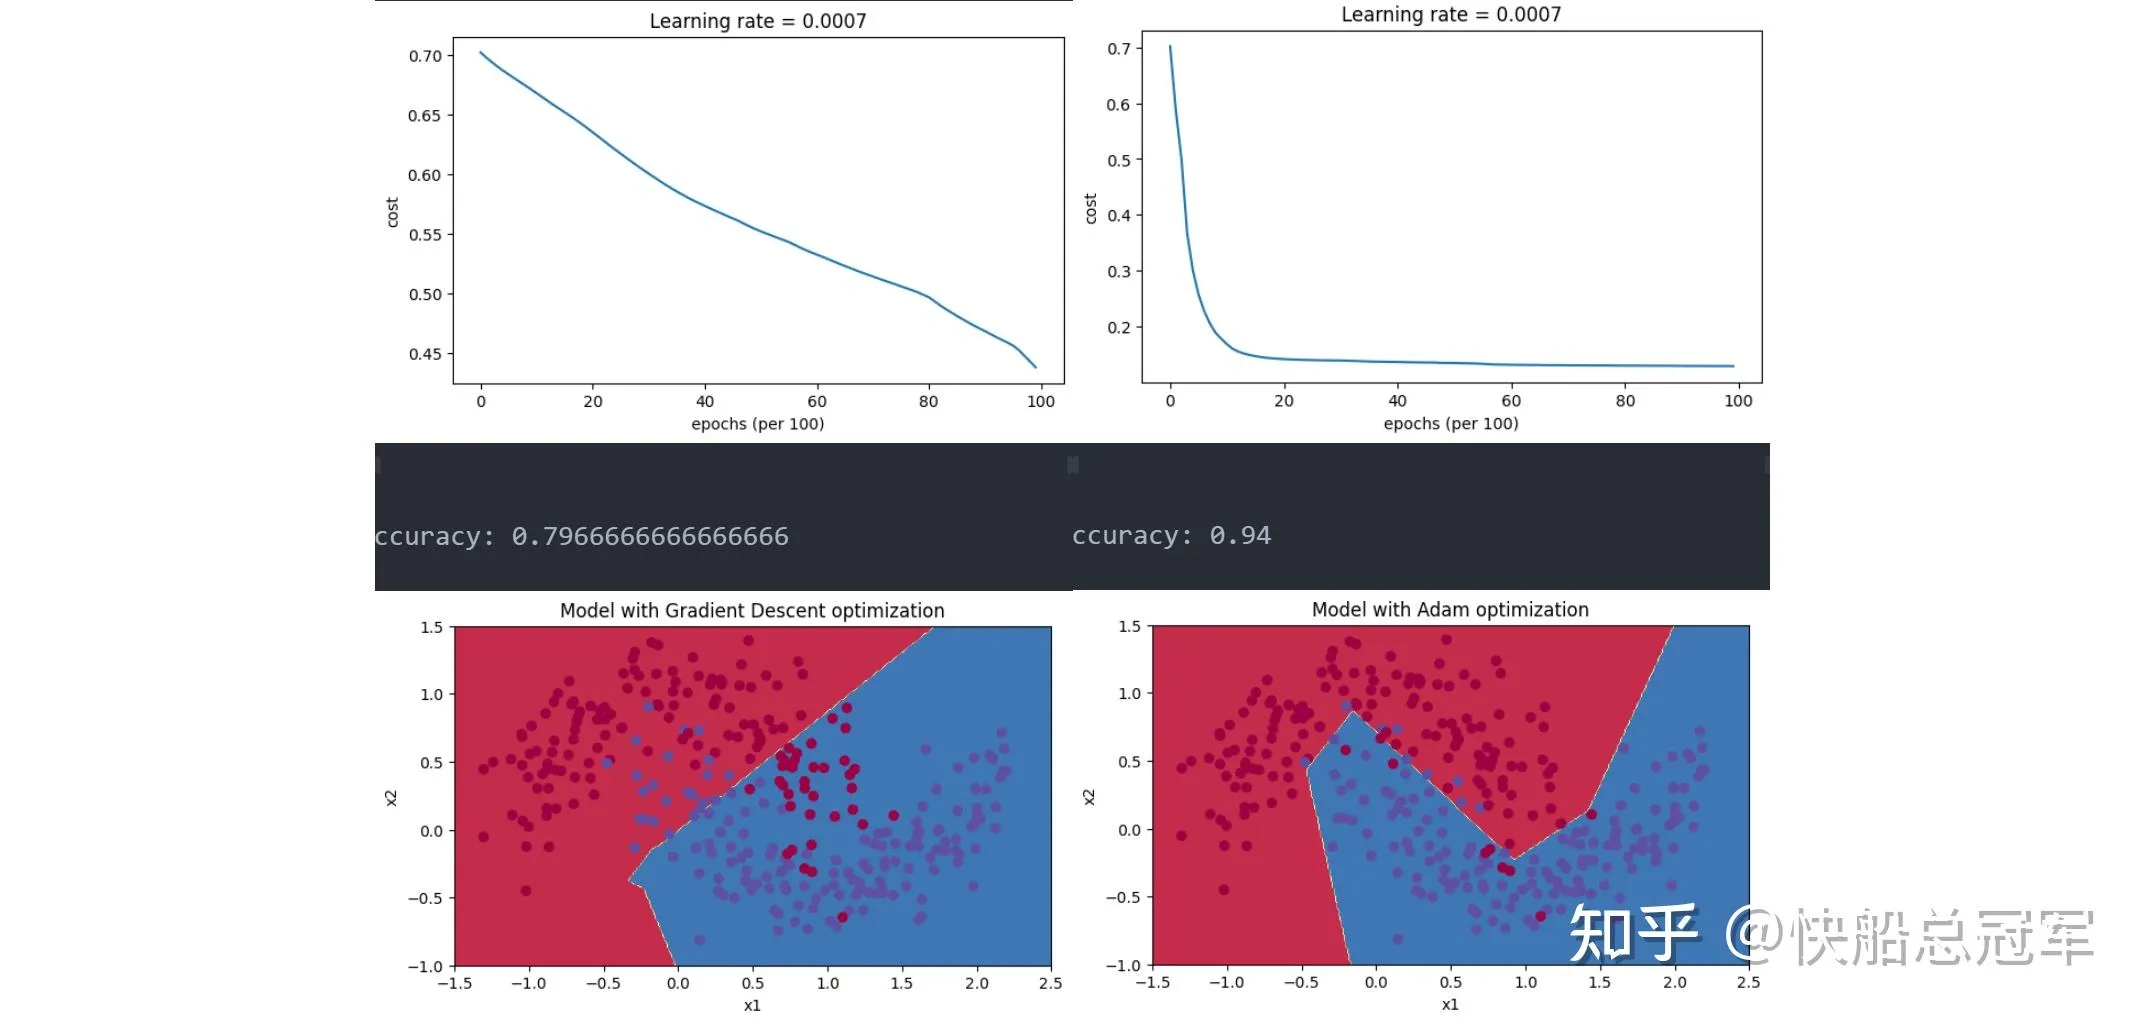
gradient descent& adam
综上所述,Mini-Batch training以及Adam 优化方法在实际的使用中是非常常用的,不仅可以大大的加快我们训练的iteration数量,同时也可以加快我们收敛的速率以及准确率。我们在自己进行模型训练的时候,可以考虑使用这两者。