CS230的最后一块内容是介绍关于RNN的,个人感觉Andrew Ng在RNN网络的介绍上非常详细,但是对于NLP&LLM部分就显得不太行了,本文中我们将会就RNN网络的来龙去脉进行介绍,对于RNN的应用我们将会留到cs224n中进行介绍。
RNN#
我们的需要对一段语句进行处理,对于输入的形式为单词 ,其中 为一个单词的独热编码。通常对于输入的最后我们会添加一个 来标志一段话的结束。
Basic RNN(输入=输出)#
RNN的主要想法是将单词依次输入,并且使用变量 来记录t时刻输入后对于语句语意 的记录。按照输入顺序依次罗列,更新 并且输出 ,这种顺序的输入结构就是RNN,其网络结构为
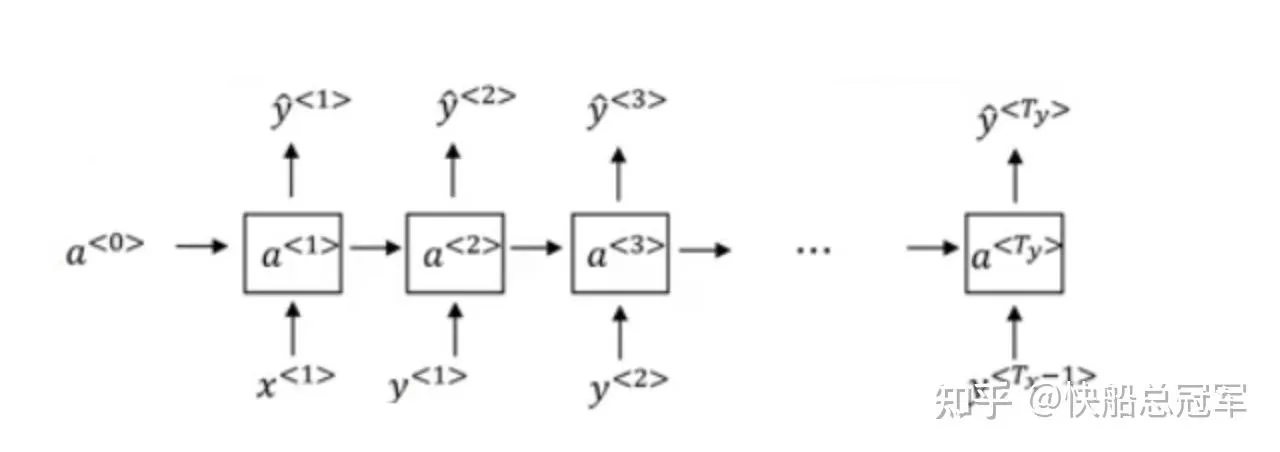
前向传播
- t时刻的输入 输出为 。起初
- t时刻对于 进行更新
由此对于一段语言输入便可以得到相应的输出,同时可以记录当前的语句的语意 思,这便是最基本的RNN.
反向传播
我们对于任意时刻t而言, 为每一个单词出现的概率,而如果我们有标签数据 的话,可以有损失函数 于是只要做好** 标签数据**即可实现最为基础的RNN。
Encoder & Decoder RNN#
在机器翻译的时候,可能不一定是一个单词输入对应一个单词输出。一般的,我们需要理解前一段话的语义(Encoder)之后再进行整体的翻译部分(Decoder)。于是我们需要在原有的RNN上进行改进。
- Encoder :对于输入部分,我们不需要有输出,只需要对于 进行更新,即为 ,直到输入停止
- Decoder :对于输出部分,由于 记录的是之前的状态,对于此部分的输入为 。此时我们没有了x这个东西,但是可以将 上一个时刻的输出作为下一个时刻的输入,图形以及数学表示为
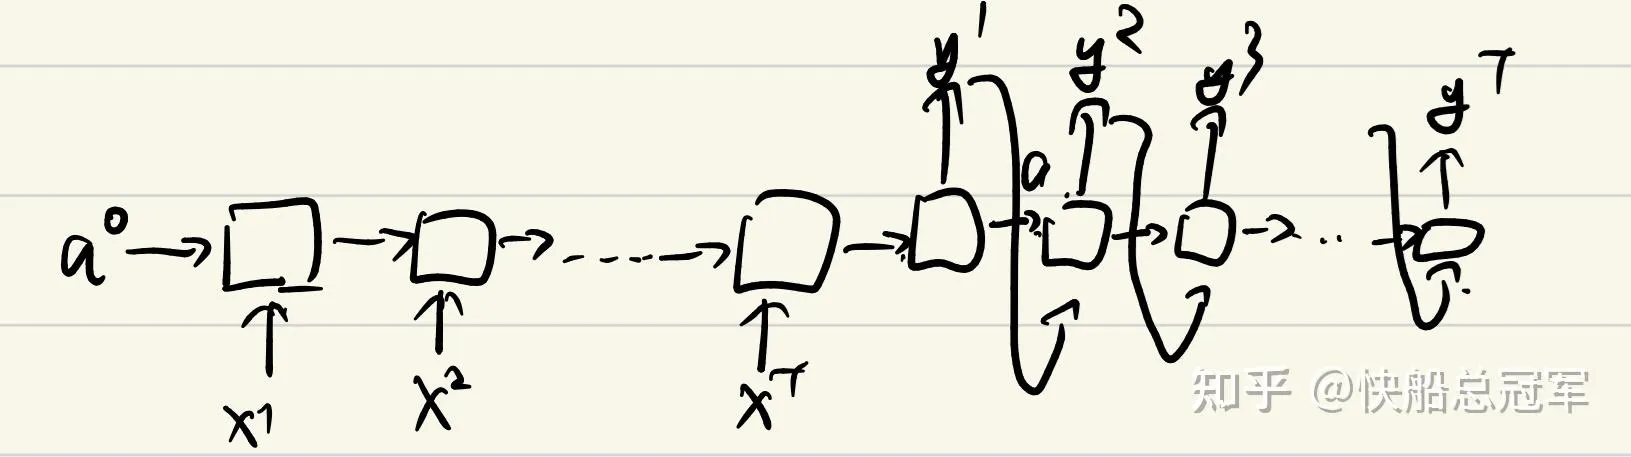
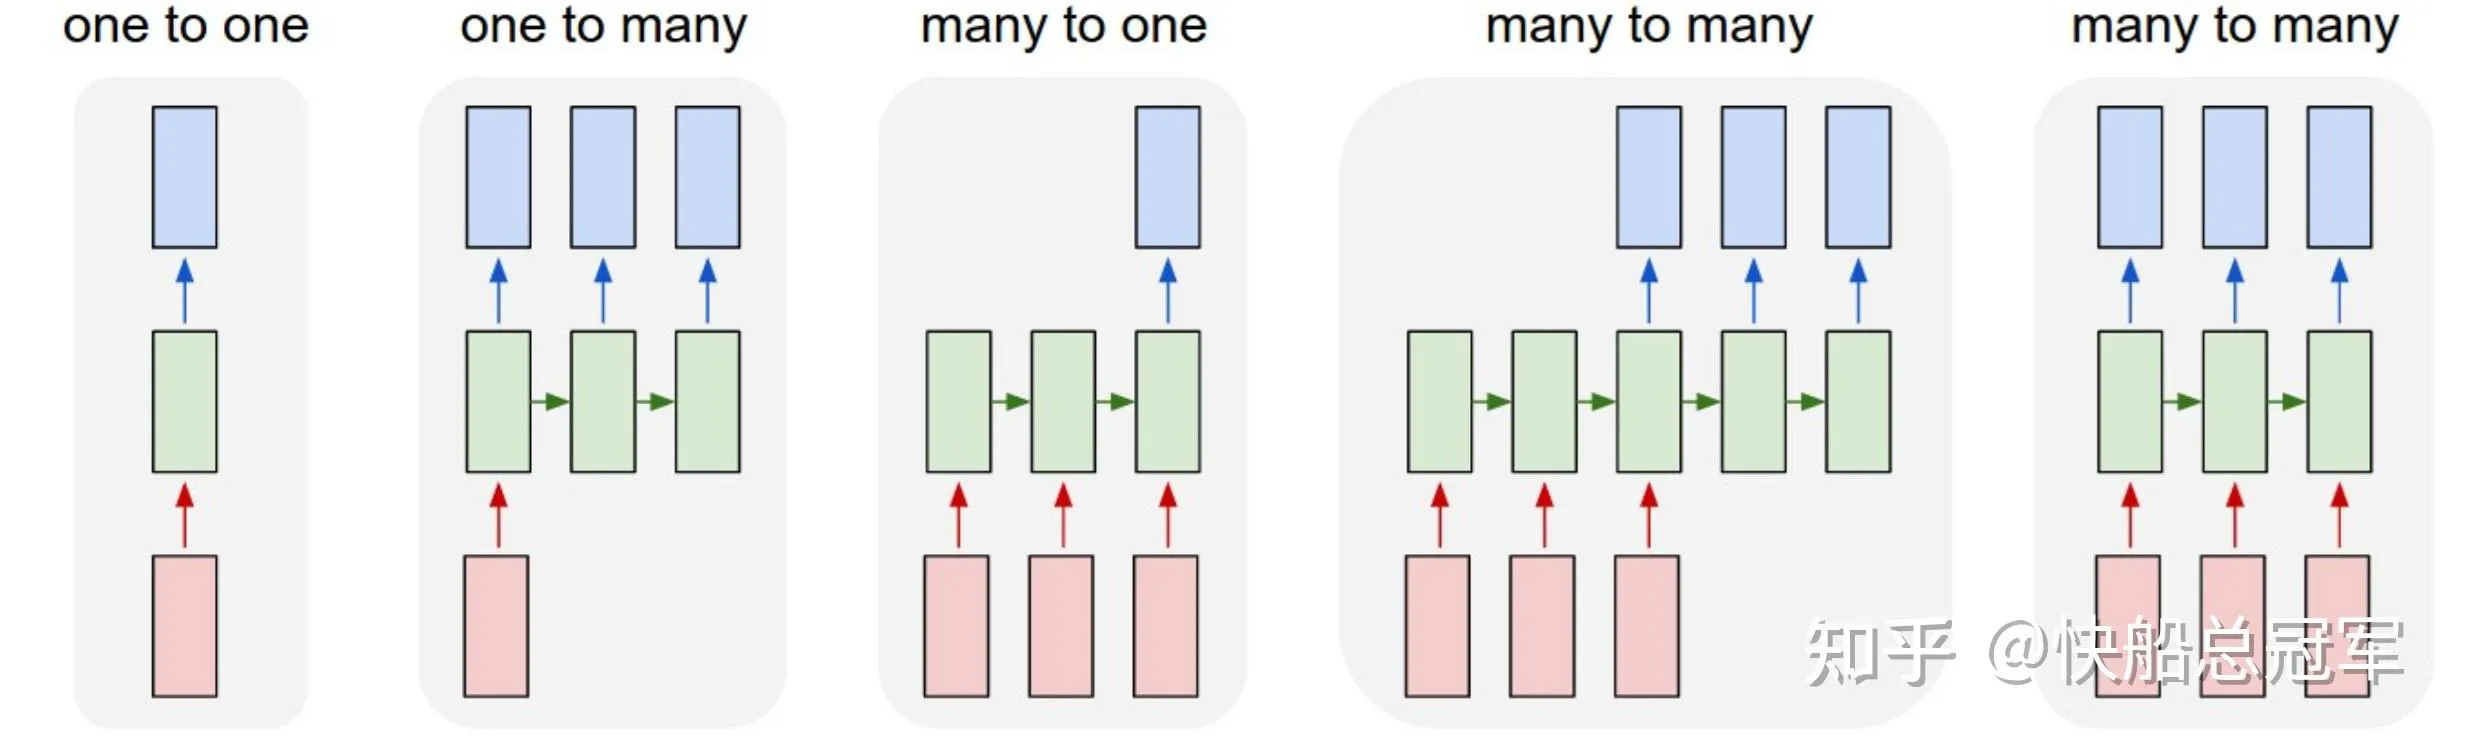
Decoder RNN给了我们一个提示,a为记录语句状态的,而如果需要输出,将最后时刻的a经** 过想要的结构**(可以是Fully Connect,也可以是别的结构),最后得到想要的输出。
RNN训练时的常见问题#
再来看一下我们的网络结构图
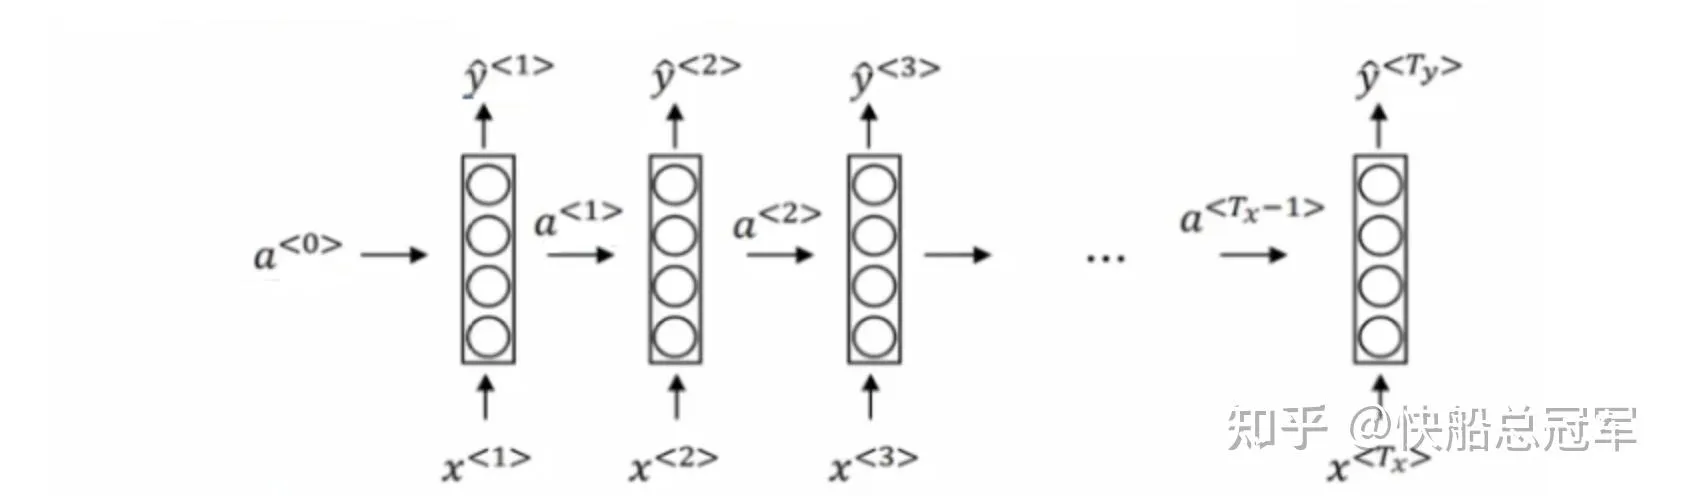
可以发现这个过程中有一个非常长的传播的路径,于是我们再进行反向传播的时候就非常容易发生** 梯度爆炸或者消失**。于是这个过程中就需要(1)梯度裁剪或者放大 (2)batch-norm可以对整体的梯度进行调整 (3)合适的初始化
对于以上的RNN而言,每一个输入对于我们的记忆的影响都是一样的,但是就想”a”,“is”之类的词语和一些动词,名词的作用是不相同的,于是我们就需要对于** 记忆力机制进行改进**。我们使用** 门来控制记忆的遗忘,更新,不变(GRU&LSTM),同时我们的语义理解应该是区域性的而不是顺序的,因此就需要使用 双向RNN**来控制记忆。
GRU(Gated Recurrent Unit)#
GRU的核心思想:对于记忆有两个状态,** 更新和 维持**,我们通过设置一个“门”(也就是一个变量)来控制这两者。
GRU对于t时刻的输入 想要得到下一个时刻的输出
** basic GRU**
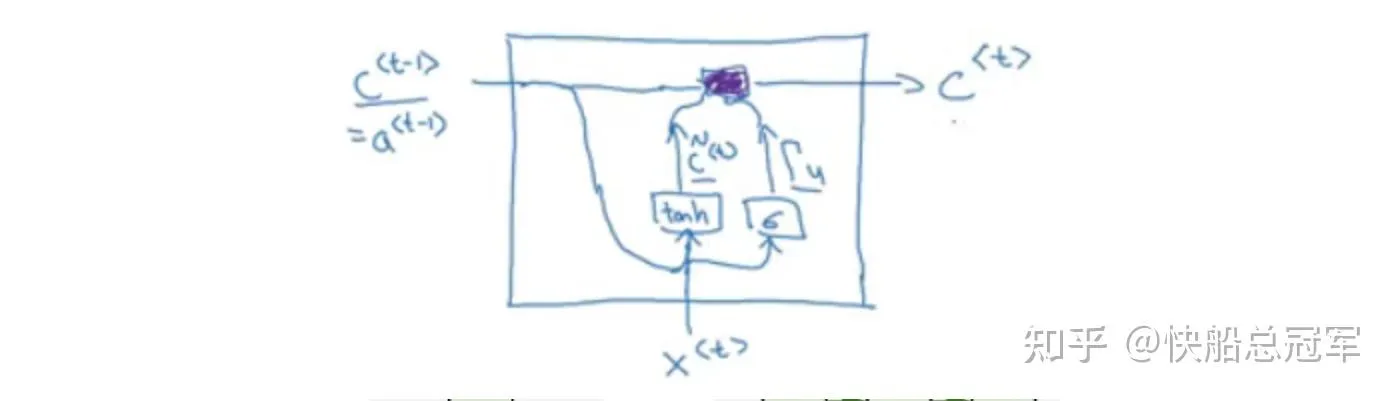
- 对于门的实现,我们会使用sigmoid得到一个**“gate”** :通过0&1来决定是否要进行更新,具体数学为
- 而我们对于记忆的更新,首先得到一个备选 的更新后的记忆
- 最后根据门来决定是维持原有的记忆还是更新记忆:如果gate为false,那么就将 赋给 。反之将备选的记忆赋值给 。即为
图形化表示即为
Fully GRU
考虑到有的时候有的输入会突然对整体的意思产生非常大的影响,如否定词会直接取反整句的意思,于是我们需要对于 的输入 选项添加另外一个门来处理
\begin{align*} \tilde{a}^{<t>} &= \tanh(W_c [\Gamma_r \odot a^{<t-1>}, x^{<t>}] + b_c) \\ \Gamma_u &= \sigma(W_u [a^{<t-1>}, x^{<t>}] + b_u) \\ \Gamma_r &= \sigma(W_r [a^{<t-1>}, x^{<t>}] + b_r) \\ a^{<t>} &= \Gamma_u \odot \tilde{a}^{<t>} + (1 - \Gamma_u) \odot a^{<t-1>} \end{align*}
使用以上方法,总共只要用原有RNN的2-3倍的参数就有比较好的效果。是一种速度比较快的方法。
LSTM(Long short term memory)#
LSTM是一种更加复杂的记忆力机制,在英文输入的时候,有的时候可能会先说一堆废话,然后“言归正传”,或者是最一开始有一个总起句子,需要进行长时间的记忆,为了实现这种长短记忆力机制,我们需要设计更加复杂的结构。
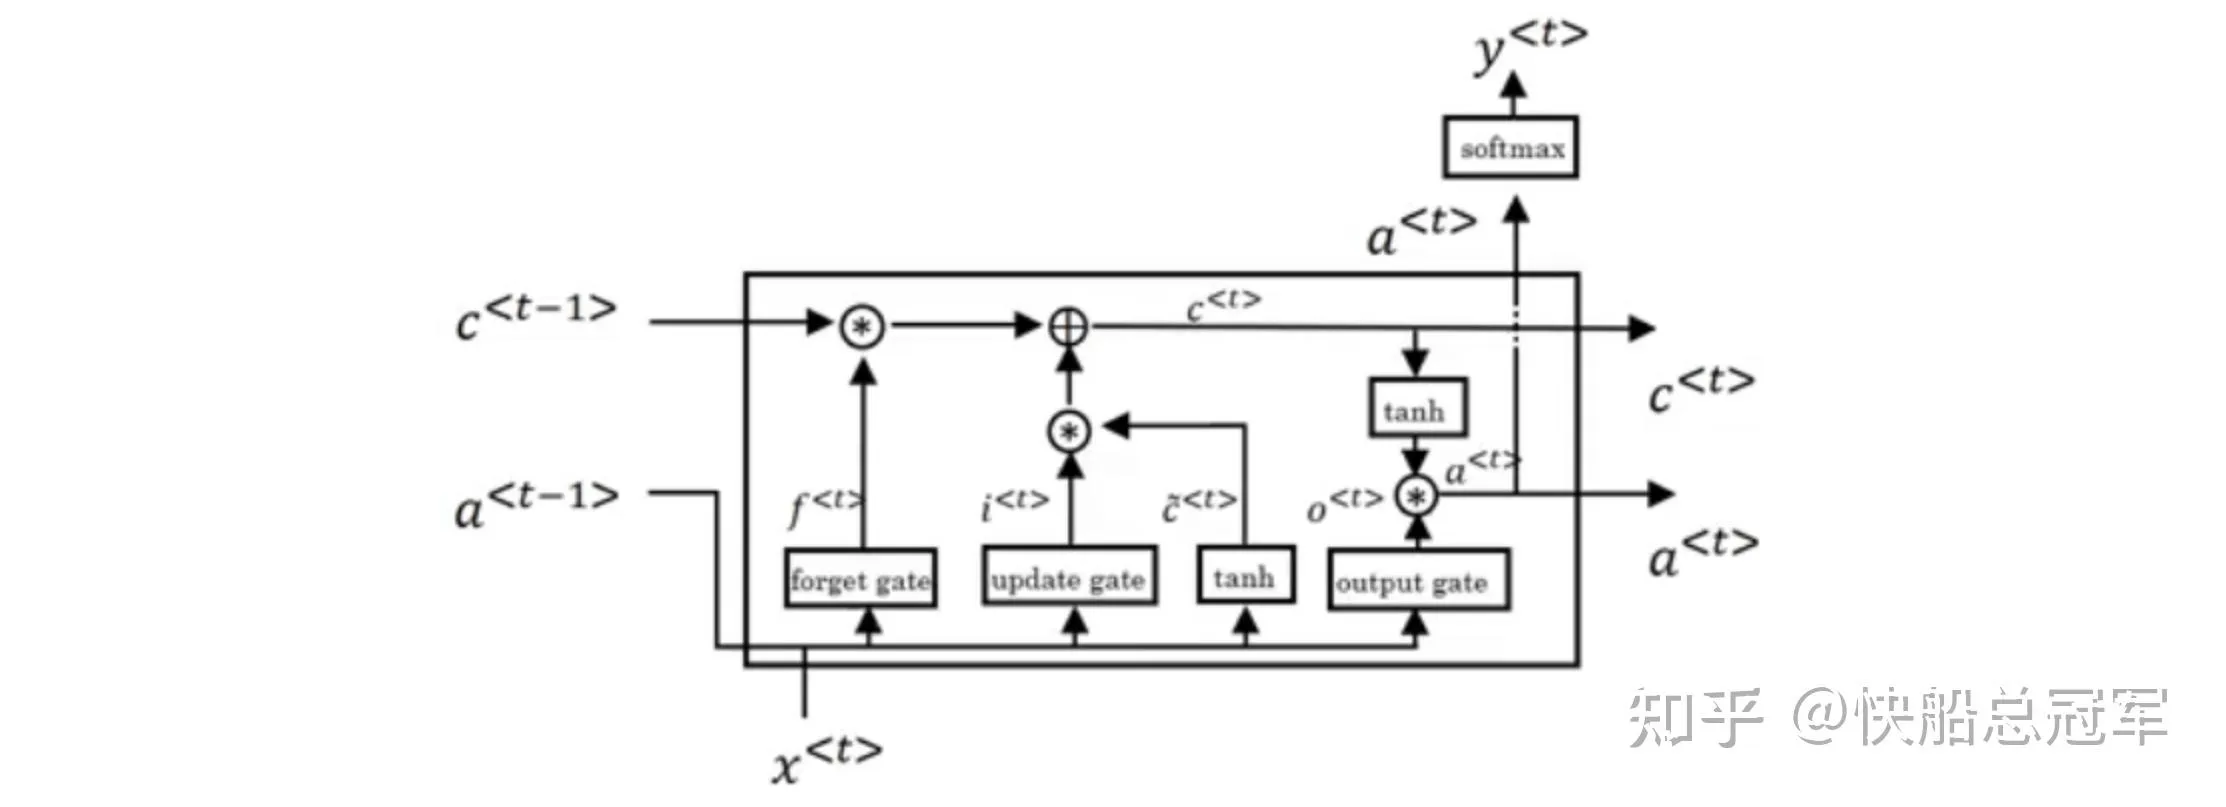
- 对于长短记忆力 :之前我们都是使用单个记忆力 进行记忆,接下来我们将会使用 来表示短期的记忆,而 表示长期的记忆
- LSTM设置了3个状态 :遗忘过去内容并添加新内容,遗忘所有的内容,保持现有的内容 。因此我们需要一个控制“遗忘过去”,“遗忘现在”的门,并且最后需要将两个门整合起来,有一个控制”遗忘所有内容”的门。
\begin{align} \Gamma_{past} &= \sigma(W_{past} [a^{<t-1>}, x^{<t>}] + b_{past}) \\ \Gamma_{present} &= \sigma(W_{present} [a^{<t-1>}, x^{<t>}] + b_{present}) \\ \Gamma_{all} &= \sigma(W_{all} [a^{<t-1>}, x^{<t>}] + b_{all}) \end{align}
- 对于长期&短期记忆
的更新思路
通过以上的步骤就可以做到更新长期的记忆 ,并且由此得到短期的记忆 的更新。其图形化表示为
B-RNN#
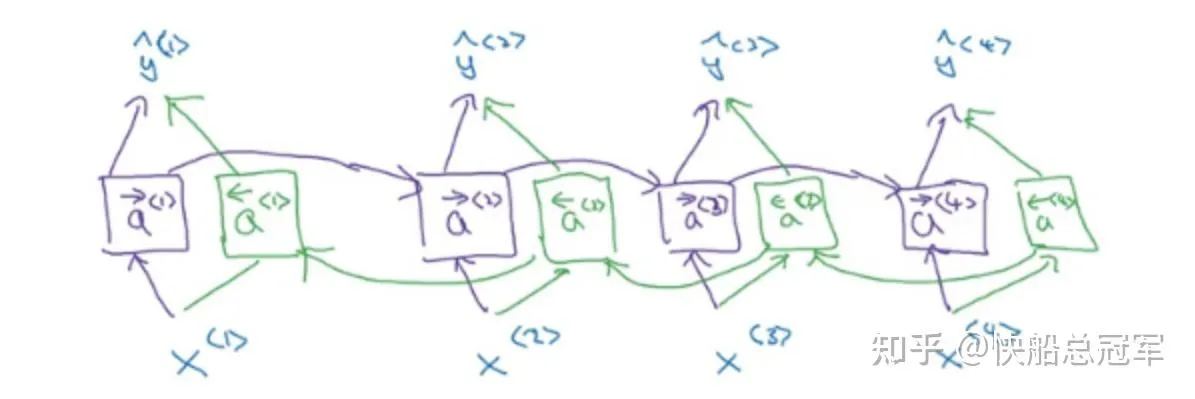
之前我们所有的输出都是线性输入,每一个单词的理解只会根据其前文的内容,但是真实情况是会根据上下文进行理解的。于是我们会使用双向RNN: 先从头到尾进行阅读,得到记忆 ,然后从尾到头读,得到记忆 ,最后一起得到最后的输出从图片上可以看出来,这个网络实际上就是两个RNN拼接起来的结果。
以上就是RNN的基本结构部分,对于传统的RNN,个人感觉最重要的是记忆力 的实现与理解,尤其是长短期的记忆力,以后的transformer中即使有非常长的文本,我们没有办法全部输入进网络,需要做的仍然是通过记忆力的方式去进行记忆。
RNN应用#
RNN第一个应用就是对于一段语言的处理,而对于语言的处理,即为每一个单词的表示形式从最一开始的独热编码 变为Word Embedding 。
对于变成了word Embedding之后的处理我们现在使用的是Transformer。
Transformer
- self attention:其中(Q,K,V)可以认为是我们对于每一个单词的理解认为是一个查询,而查询会影响到我们对于这个单词的理解方式,最后加上相应的权重V,即为
这里的(Q,K,V)为对于输入单词经过相应的矩阵 产生的。
self attention的输入是单词的embedding ,而输出为在经过attention处理之后的应该被认识的方式(每一个单词对应着一个向量 )
- Multi-Head attention,类似于多重卷积核,对于self attention我们使用多个,就可以得到对于每一个单词的不同的理解方式,,最后经过一个全连接,得到对于每一个单词的理解方式(一个向量)
- Transformer:我们不考虑add&norm,即为
Encoder部分 :单词输入,经过multi-hear attention之后得到一些输出
Decoder部分 :输入为之前的单词,Encoder对于单词的理解,经过Attention后的一些基本知识,以上的部分经过Attention之后concat起来,最后经过一个softmax得到输出。
具体的部分我们留到cs224n中详细讨论。
Word Embedding
而对于word Embedding而言,我们知道了它是非常重要的,每一个单词对应的向量就表示了它的意思在不同维度的比重。
而训练word Embedding的数据集的构建为从一段文字中挑选的若干个,对于这一块的训练过程我留到CS224n去讨论。
机器翻译的评判标准我们会使用Bleu score,简单而言就是分别考察1个单词,2个单词。。。多个单词预测成功的概率并进行奖励惩罚。
对于RNN的应用远远不止机器翻译一个领域,它还可以应用到任何线性输入的东西之中。在cs224n中我们将会详细学习这一部分的内容。