生成式AI是目前的一个热点方向,类似于cs229中的无监督学习,都是通过训练数据集去学习到如何进行预测/生成结果 ,只是对于无监督学习中目标(将数据进行合理的分类/提取),评估方法都有较为简单的数学形式,而本文将会介绍对于生成式AI的生成原理,基本模型,训练目标,训练预测过程。
生成式AI的生成原理#
Gnerative AI,输入一串指令y,我们希望基于指令生成一张图片,那么就会得到一个X, 而如果我们让他再生成一张,常常会生成一张不一样的。
** 目标**:由于我们的每一次“希望AI生成一张图片”相当于一次查询取样,之际上就可以认为我们是从一个概率分布中去抽取一个样本,这提示我们Generative AI的目标是生成一个** 概率**。也就是对于所有的问题都要从概率论的角度去思考
** 初始化**:实际上,如果我们进行任何的训练,就是一个啥都不会的模型,那么对于你输入任何的指令,它应该都只会输出一堆的噪声。即原始模型只会进行随机的输出
** 数据集**:对于一张图片我们可以看成是由RGB三种颜色(3个通道的)大小为 H e i g h t × W e i g h t Height\times Weight He i g h t × W e i g h t ∈ R C × H × W \in R^{C\times H\times W} ∈ R C × H × W R T × C × H × W R^{T\times C\times H \times W} R T × C × H × W z ∈ R d z\in R^d z ∈ R d
于是我们拥有的是 ( z s a m p l e , y s a m p l e ) (z_{sample},y_{sample}) ( z s am pl e , y s am pl e ) p d a t a ( z , y ) p_{data}(z,y) p d a t a ( z , y )
中抽取的样本。
因此对于生成式AI也就是:
通过巨大的训练数据集作为随机抽样的样本 ,作为希望得到的概率分布 p d a t a ( z , y ) p_{data}(z,y) p d a t a ( z , y )
训练目标 :将模型由初始的 p i n i t p_{init} p ini t 变换关系 ,使得对于任何的y,都可以得到 p ^ t a r g e t ( x , y ) \hat{p}_{target}(x,y) p ^ t a r g e t ( x , y ) 通过某种评估手段 ,使得 p ^ t a r g e t ( x , y ) \hat{p}_{target}(x,y) p ^ t a r g e t ( x , y ) p d a t a ( z , y ) p_{data}(z,y) p d a t a ( z , y ) 最后基于给的输入y,从 p ^ d a t a ( . ∣ y ) \hat{p}_{data}(.|y) p ^ d a t a ( .∣ y )
我们对于 p i n i t p_{init} p ini t 端到端 的学习 p d a t a p_{data} p d a t a p i n i t p_{init} p ini t p d a t a p_{data} p d a t a p i n i t ⇒ p d a t a p_{init}\Rightarrow p_{data} p ini t ⇒ p d a t a
演化的数学表达:微分方程#
所谓的概率分布的“演化” ,就是对于其空间 的一个变化,对于任意 X 0 ∈ R d X_0\in R^d X 0 ∈ R d X t = f ( X 0 ) X_t=f(X_0) X t = f ( X 0 ) X t ∈ R d X_t\in R^d X t ∈ R d X 0 ∼ p i n i t X_0\sim p_{init} X 0 ∼ p ini t X t ∼ p t X_t\sim p_{t} X t ∼ p t
因此我们最好的描述工具为微分方程 , 从简单考虑,使用一阶微分方程去进行描述,结合需要加上一定的随机性,我们使用** ODE(ordinary differential equations)以及 SDE(stochastic differential equations)**去描述
ODE以及Flow Models#
** ODE**以 R d R^d R d X 0 X_0 X 0 ϕ t ( X 0 ) \phi_t(X_0) ϕ t ( X 0 ) ϕ 0 ( X 0 ) = x 0 \phi_0(X_0)=x_0 ϕ 0 ( X 0 ) = x 0 t ∈ [ 0 , 1 ] t\in [0,1] t ∈ [ 0 , 1 ]
假设在t时刻物体的“速度”为 u t ( ϕ ( X 0 ) ) u_t(\phi(X_0)) u t ( ϕ ( X 0 )) u : R d × [ 0 , 1 ] → R d , ( x , t ) ↦ u t ( x ) , u: \mathbb{R}^d \times [0,1] \to \mathbb{R}^d, \quad (x,t) \mapsto u_t(x), u : R d × [ 0 , 1 ] → R d , ( x , t ) ↦ u t ( x ) ,
d d t ϕ t ( X 0 ) = u t ( ϕ t ( X 0 ) ) \dfrac{\mathrm{d}}{\mathrm{d}t} \phi_t(X_0) = u_t(\phi_t(X_0)) d t d ϕ t ( X 0 ) = u t ( ϕ t ( X 0 ))
ϕ 0 ( X 0 ) = X 0 \phi_0(X_0)=X_0 ϕ 0 ( X 0 ) = X 0
** Flow Models**
对于 ϕ \phi ϕ X 0 ∼ p i n i t X_0\sim p_{init} X 0 ∼ p ini t ϕ t ( X 0 ) \phi_t(X_0) ϕ t ( X 0 ) ϕ 1 ( X 0 ) ∼ p d a t a \phi_1(X_0)\sim p_{data} ϕ 1 ( X 0 ) ∼ p d a t a ϕ t ( X 0 ) \phi_t(X_0) ϕ t ( X 0 ) X t X_t X t
d d t X t = u t θ ( X t ) \dfrac{\mathrm{d}}{\mathrm{d}t} X_t = u_t^{\theta}(X_t) d t d X t = u t θ ( X t )
X 0 ∼ p i n i t X_0\sim p_{init} X 0 ∼ p ini t
我们通过训练神经网络 u t θ u_t^{\theta} u t θ X 1 ∼ p d a t a X_1\sim p_{data} X 1 ∼ p d a t a
** 模拟Flow Models过程**
由于flow models是一个分布到分布的变化,我们模拟的方法是** 多次从 p i n i t p_{init} p ini t
而我们的ODE中的时间是连续的,为了模拟这个过程,我们使用** Euler Method**来模拟:将[0,1]划分为h大小的时间段,对于这段时间内用 X t + h − X t h \dfrac{X_{t+h}-X_t}{h} h X t + h − X t d d t X t \dfrac{d}{dt}X_t d t d X t
伪代码即为:
## sampling from a flow model with Euler method
step1: set t=0, h=1/n
step2: draw a sample X0~pinit
for i =1,...n-1:
    X[t+h]=X[t]+h*ut(Xt)
    t:=t+h
return X1
plaintext
总结即为使用取样作为分布观察分布变化情况
SDE & Diffusion Models#
在ODE中我们是使用一个 d d t X t = u t θ ( X t ) \dfrac{\mathrm{d}}{\mathrm{d}t} X_t = u_t^{\theta}(X_t) d t d X t = u t θ ( X t ) u t θ , X 0 u_t^\theta,X_0 u t θ , X 0
** 布朗运动(连续形式的markov过程)**
对于一个布朗过程 W = ( W t ) 0 ≤ t ≤ 1 W=(W_t)_{0\leq t\leq 1} W = ( W t ) 0 ≤ t ≤ 1 W 0 = 0 W_0=0 W 0 = 0
独立增量 :对于任意的 0 ≤ t 0 ≤ t 1 . . . ≤ t n = 1 0\leq t_0\leq t_1 ...\leq t_n=1 0 ≤ t 0 ≤ t 1 ... ≤ t n = 1 W t 1 − W t 0 , . . . W t n − W t n − 1 W_{t_1}-W_{t_0},...W_{t_n}-W_{t_{n-1}} W t 1 − W t 0 , ... W t n − W t n − 1 正态增量 :对于任何的 0 ≤ s ≤ t ≤ 1 0\leq s \leq t \leq 1 0 ≤ s ≤ t ≤ 1 W t − W s ∼ N ( 0 , ( t − s ) I d ) W_t - W_s \sim \mathcal{N}(0, (t-s)I_d) W t − W s ∼ N ( 0 , ( t − s ) I d )
即为任意小的时间段内,位置的变化都可以认为是一个正态分布。
想要模拟布朗运动,我们仍然可以将[0,1]划分成n个长h的区间,只是由于正态增量原则,我们对于一个区间内的增量为 h ∗ N ( 0 , I d ) \sqrt{h}*\mathcal{N}(0, I_d) h ∗ N ( 0 , I d )
W_{t+h} = W_t + \sqrt{h}\, \epsilon_t,\quad \epsilon_t \sim \mathcal{N}(0, I_d) \quad (t = 0, h, 2h, \ldots, 1 - h) \tag{5}
SDE&Diffusion Models
所谓的SDE,就是在ODE的每一步上加上由布朗运动产生的贡献
X t + h = X t + h u t ( X t ) ⏟ deterministic + σ t ( W t + h − W t ) ⏟ stochastic + h R t ( h ) ⏟ error term = X t + h u t ( X t ) + σ t h ϵ t , ϵ t ∼ N ( 0 , I d ) \begin{aligned} X_{t+h} &= X_t + \underbrace{h u_t(X_t)}_{\text{deterministic}} + \sigma_t \underbrace{(W_{t+h} - W_t)}_{\text{stochastic}} + \underbrace{h R_t(h)}_{\text{error term}}\\&=X_t+hu_t(X_t)+\sigma_t \sqrt{h}\epsilon_t,\epsilon_t\sim \mathcal{N}(0, I_d) \end{aligned} X t + h = X t + deterministic h u t ( X t ) + σ t stochastic ( W t + h − W t ) + error term h R t ( h ) = X t + h u t ( X t ) + σ t h ϵ t , ϵ t ∼ N ( 0 , I d )
写成方程的形式即为 d X t = u t ( X t ) d t + σ t d W t \mathrm{d}X_t = u_t(X_t)\,\mathrm{d}t + \sigma_t\,\mathrm{d}W_t d X t = u t ( X t ) d t + σ t d W t X 0 ∼ p i n i t X_0\sim p_{init} X 0 ∼ p ini t
## sampling from a diffusion model using Euler-Maruyama method
step1: set t=0, h=1/n
step2: draw a sample X0~pinit
for i =1,...n-1:
    draw a sample \epsilon ~ N(0,Id)
    X[t+h]=X[t]+h*ut(Xt)+sigma[t]\sqrt{h}\epsilon
    t:=t+h
return X1
plaintext
使用SDE/ODE作为数学基础,通过训练 u t θ u_t^{\theta} u t θ p i n i t ⇒ p d a t a p_{init}\Rightarrow p_{data} p ini t ⇒ p d a t a
建立训练的目标#
通过第二部分,我们已经知道Flow Model d d t X t = u t θ ( X t ) \dfrac{\mathrm{d}}{\mathrm{d}t} X_t = u_t^{\theta}(X_t) d t d X t = u t θ ( X t )
由于我们有的东西是数据集,即有大量的 x x x u t θ ( x ) u_t^\theta(x) u t θ ( x ) Supervised Learning 的想法:
希望造出一些标签数据 ,从而将损失函数定义为 L ( θ , x , t ) = Σ i = 1 m ∥ u t θ ( x i ) − u t target ( x i ) ∥ 2 \mathcal{L}(\theta,x,t) = \Sigma^m_{i=1}\| u_t^\theta(x_i) - u_t^{\text{target}}(x_i) \|^2 L ( θ , x , t ) = Σ i = 1 m ∥ u t θ ( x i ) − u t target ( x i ) ∥ 2
于是我们的目标就变成了** 寻找一个对于training target的等式 u t t a r g e t u_t^{target} u t t a r g e t
演化路径#
我们建立该等式的中心思想是:为了寻找 u t θ ( x ) u_t^\theta(x) u t θ ( x ) z ∼ p d a t a z\sim p_{data} z ∼ p d a t a u t ( x ∣ z ) u_t(x|z) u t ( x ∣ z ) u t ( x ) u_t(x) u t ( x ) p t ( X ) p_t(X) p t ( X )
条件演化路径 :对于任何的 z ∈ R d z\in R^d z ∈ R d p 0 ( ⋅ ∣ z ) = p init , p 1 ( ⋅ ∣ z ) = δ z p_0(\cdot \mid z) = p_{\text{init}}, \quad p_1(\cdot \mid z) = \delta_z p 0 ( ⋅ ∣ z ) = p init , p 1 ( ⋅ ∣ z ) = δ z p 0 ( ∣ z ) ⇒ p 1 ( ∣ z ) p_0(|z)\Rightarrow p_1(|z) p 0 ( ∣ z ) ⇒ p 1 ( ∣ z ) 边缘演化路径 :也就是对于 p d a t a ( z ) p_{data}(z) p d a t a ( z ) z ∼ p data , x ∼ p t ( ⋅ ∣ z ) ⇒ x ∼ p t , p t ( x ) = ∫ p t ( x ∣ z ) p data ( z ) d z z \sim p_{\text{data}}, \quad x \sim p_t(\cdot \mid z) \Rightarrow x \sim p_t ,\quad p_t(x) = \int p_t(x \mid z) p_{\text{data}}(z)\, dz z ∼ p data , x ∼ p t ( ⋅ ∣ z ) ⇒ x ∼ p t , p t ( x ) = ∫ p t ( x ∣ z ) p data ( z ) d z
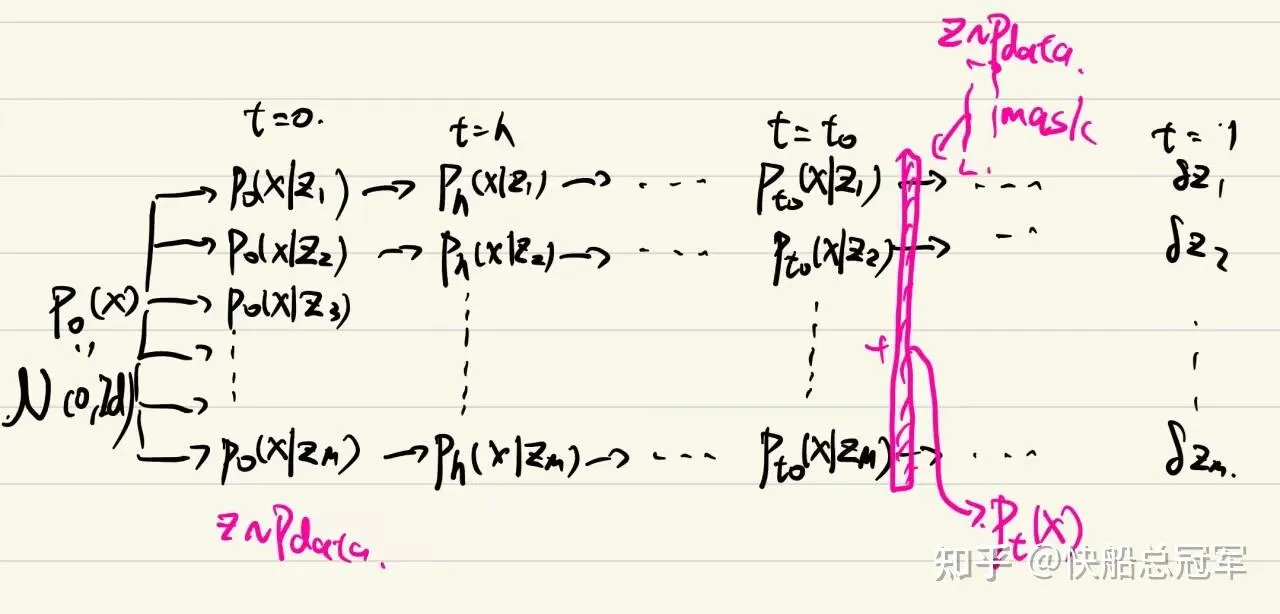
对于这两者我的形象化的理解是:条件演化路径中 p t ( . ∣ z ) p_t(.|z) p t ( .∣ z ) t = 0 , h , . . . . .1 t=0,h,.....1 t = 0 , h , .....1
将 p 0 ( x ) p_0(x) p 0 ( x ) p 0 ( x ∣ z ) p_0(x|z) p 0 ( x ∣ z )
然后通过某种操作对于 p t ( x ∣ z ) p_t(x|z) p t ( x ∣ z ) p 1 ( x ∣ z ) p_1(x|z) p 1 ( x ∣ z )
最后得到对于每一个 p 1 ( . ∣ z ) p_1(.|z) p 1 ( .∣ z )
如果我们需要计算 p t ( X ) p_t(X) p t ( X ) p d a t a ( z ) p_{data}(z) p d a t a ( z ) p t ( x ∣ z ) p_t(x|z) p t ( x ∣ z ) p t ( x ) p_t(x) p t ( x )
网络图形可以看成是
可以发现,对于边缘演化路径而言,当 z ∼ p d a t a z\sim p_{data} z ∼ p d a t a p t ( x ) = ∫ z δ z p d a t a ( z ) d z = p d a t a ( z ) p_t(x)=\int_z\delta_z p_{data}(z)dz=p_{data}(z) p t ( x ) = ∫ z δ z p d a t a ( z ) d z = p d a t a ( z )
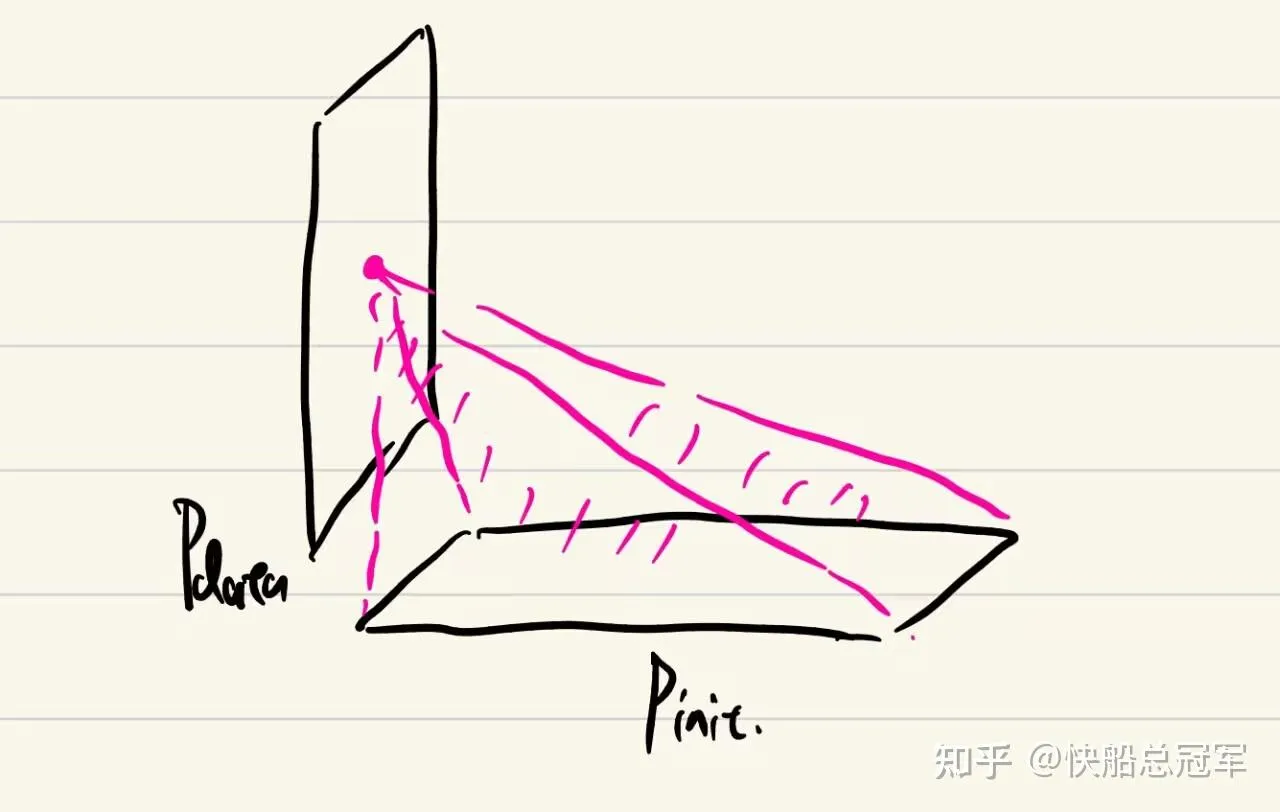
由于我们的 p i n i t p_{init} p ini t 噪声数据 高斯分布 N ( 0 , I d ) \mathcal{N} (0,I_d) N ( 0 , I d ) p i n i t p_{init} p ini t p d a t a p_{data} p d a t a p t ( x ) p_t(x) p t ( x )
条件速度以及边缘速度#
原文中是使用向量场去描述,但是我觉得使用速度场 更加的形象。
由于我们一般而言是定义了从 p t ( x ∣ z ) p_t(x|z) p t ( x ∣ z ) 总线上的一根支线,最后使用掩码去合 成,因此对于求解这个速度形式的话,也可以使用这种方法。
如果我们可以求解出来 u t t a r g e t ( X t ∣ z ) u_t^{target}(X_t|z) u t t a r g e t ( X t ∣ z )
1.从 p t ( x ∣ z ) p_t(x|z) p t ( x ∣ z ) u t t a r g e t ( X t ∣ z ) u_t^{target}(X_t|z) u t t a r g e t ( X t ∣ z ) #
由于我们有 d d t X t = u t ( X t ∣ z ) \dfrac{d}{dt}X_t=u_t(X_t|z) d t d X t = u t ( X t ∣ z ) X t = p t ( x ∣ z ) X_t=p_t(x|z) X t = p t ( x ∣ z ) d d t p t ( x ∣ z ) = u t ( p t ( x ∣ z ) ) \dfrac{d}{dt}p_t(x|z)=u_t(p_t(x|z)) d t d p t ( x ∣ z ) = u t ( p t ( x ∣ z ))
2.从 u t t a r g e t ( X t ∣ z ) u_t^{target}(X_t|z) u t t a r g e t ( X t ∣ z ) u t t a r g e t ( X t ) u_t^{target}(X_t) u t t a r g e t ( X t ) #
对于这个可以通过如下定理内容实现
定理1: 对于 z ∈ R d z\in R^d z ∈ R d u t t a r g e t ( . ∣ z ) u_t^{target}(.|z) u t t a r g e t ( .∣ z ) X 0 ∼ p i n i t ⇒ X t ∼ p t ( . ∣ z ) X_0\sim p_{init} \Rightarrow X_t\sim p_t(.|z) X 0 ∼ p ini t ⇒ X t ∼ p t ( .∣ z ) d d t X t = u t t a r g e t ( . ∣ z ) \dfrac{d}{dt}X_t=u_t^{target}(.|z) d t d X t = u t t a r g e t ( .∣ z ) u t target ( x ) = ∫ u t target ( x ∣ z ) p t ( x ∣ z ) p data ( z ) p t ( x ) d z u_t^{\text{target}}(x) = \int u_t^{\text{target}}(x|z) \frac{p_t(x|z)p_{\text{data}}(z)}{p_t(x)} \,\mathrm{d}z u t target ( x ) = ∫ u t target ( x ∣ z ) p t ( x ) p t ( x ∣ z ) p data ( z ) d z
可以使得 X 0 ∼ p i n i t ⇒ X t ∼ p t ( x ) X_0\sim p_{init} \Rightarrow X_t\sim p_t(x) X 0 ∼ p ini t ⇒ X t ∼ p t ( x ) d d t X t = u t t a r g e t ( X t ) \dfrac{d}{dt}X_t=u_t^{target}(X_t) d t d X t = u t t a r g e t ( X t )
定理2 :对于 z ∈ R d z\in R^d z ∈ R d u t t a r g e t ( . ∣ z ) u_t^{target}(.|z) u t t a r g e t ( .∣ z ) X 0 ∼ p i n i t ⇒ X t ∼ p t ( . ∣ z ) X_0\sim p_{init} \Rightarrow X_t\sim p_t(.|z) X 0 ∼ p ini t ⇒ X t ∼ p t ( .∣ z ) d X t = u t t a r g e t ( X t ∣ z ) d t + σ t d W t dX_t=u_t^{target}(X_t|z)dt+\sigma_t dW_t d X t = u t t a r g e t ( X t ∣ z ) d t + σ t d W t ∇ log p t ( X t ) \nabla \log p_t(X_t) ∇ log p t ( X t ) 边缘得分函数 , ∇ log p t ( x ) = ∫ ∇ log p t ( x ∣ z ) p t ( x ∣ z ) p data ( z ) p t ( x ) d z \nabla \log p_t(x) = \int \nabla \log p_t(x|z) \frac{p_t(x|z) p_{\text{data}}(z)}{p_t(x)} \,\mathrm{d}z ∇ log p t ( x ) = ∫ ∇ log p t ( x ∣ z ) p t ( x ) p t ( x ∣ z ) p data ( z ) d z
证明: 可以发现定理1实际上是定理2的在 σ t = 0 \sigma_t=0 σ t = 0
引理(Fokker-Planck Equation): 对于一个随机过程 X t = p t ( x ) X_t=p_t(x) X t = p t ( x ) d X t = u t ( X t ) d t + σ t d W t dX_t=u_t(X_t)dt+\sigma_tdW_t d X t = u t ( X t ) d t + σ t d W t ∂ t p t ( x ) = − d i v ( p t u t ) ( x ) + σ t 2 2 Δ p t ( x ) for all x ∈ R d , 0 ≤ t ≤ 1. \partial_t p_t(x) = -\mathrm{div}(p_t u_t)(x) + \frac{\sigma_t^2}{2} \Delta p_t(x) \quad \text{for all } x \in \mathbb{R}^d, 0 \leq t \leq 1. ∂ t p t ( x ) = − div ( p t u t ) ( x ) + 2 σ t 2 Δ p t ( x ) for all x ∈ R d , 0 ≤ t ≤ 1.
(引理的证明见附录)
对于定理1,则有
\begin{align*} \partial_t p_t(x) &{=} \partial_t \int p_t(x|z) p_{\text{data}}(z) \,\mathrm{d}z \\ &= \int \partial_t p_t(x|z) p_{\text{data}}(z) \,\mathrm{d}z \\ &{=} \int -\mathrm{div}\big(p_t(\cdot|z) u_t^{\text{target}}(\cdot|z)\big)(x) p_{\text{data}}(z) \,\mathrm{d}z \\ &{=} -\mathrm{div}\left( \int p_t(x|z) u_t^{\text{target}}(x|z) p_{\text{data}}(z) \,\mathrm{d}z \right) \\ &{=} -\mathrm{div}\left( p_t(x) \int u_t^{\text{target}}(x|z) \frac{p_t(x|z) p_{\text{data}}(z)}{p_t(x)} \,\mathrm{d}z \right)(x) \\ &{=} -\mathrm{div}\big(p_t u_t^{\text{target}}\big)(x), \end{align*}
定理2则为
∂ t p t ( x ) = − div ( p t u t target ) ( x ) = − div ( p t u t target ) ( x ) − σ t 2 2 Δ p t ( x ) + σ t 2 2 Δ p t ( x ) = − div ( p t u t target ) ( x ) − div ( σ t 2 2 ∇ p t ) ( x ) + σ t 2 2 Δ p t ( x ) = − div ( p t u t target ) ( x ) − div ( p t [ σ t 2 2 ∇ log p t ] ) ( x ) + σ t 2 2 Δ p t ( x ) = − div ( p t [ u t target + σ t 2 2 ∇ log p t ] ) ( x ) + σ t 2 2 Δ p t ( x ) , \begin{aligned} \partial_t p_t(x) &{=} -\operatorname{div}(p_t u_t^{\text{target}})(x) \\ &{=} -\operatorname{div}(p_t u_t^{\text{target}})(x) - \frac{\sigma_t^2}{2} \Delta p_t(x) + \frac{\sigma_t^2}{2} \Delta p_t(x) \\ &{=} -\operatorname{div}(p_t u_t^{\text{target}})(x) - \operatorname{div}\left( \frac{\sigma_t^2}{2} \nabla p_t \right)(x) + \frac{\sigma_t^2}{2} \Delta p_t(x) \\ &{=} -\operatorname{div}(p_t u_t^{\text{target}})(x) - \operatorname{div}\left( p_t \left[ \frac{\sigma_t^2}{2} \nabla \log p_t \right] \right)(x) + \frac{\sigma_t^2}{2} \Delta p_t(x) \\ &{=} -\operatorname{div}\left( p_t \left[ u_t^{\text{target}} + \frac{\sigma_t^2}{2} \nabla \log p_t \right] \right)(x) + \frac{\sigma_t^2}{2} \Delta p_t(x), \end{aligned} ∂ t p t ( x ) = − div ( p t u t target ) ( x ) = − div ( p t u t target ) ( x ) − 2 σ t 2 Δ p t ( x ) + 2 σ t 2 Δ p t ( x ) = − div ( p t u t target ) ( x ) − div ( 2 σ t 2 ∇ p t ) ( x ) + 2 σ t 2 Δ p t ( x ) = − div ( p t u t target ) ( x ) − div ( p t [ 2 σ t 2 ∇ log p t ] ) ( x ) + 2 σ t 2 Δ p t ( x ) = − div ( p t [ u t target + 2 σ t 2 ∇ log p t ] ) ( x ) + 2 σ t 2 Δ p t ( x ) ,
有了这个定理,我们就可以将 u t t a r g e t ( x ∣ z ) u_t^{target}(x|z) u t t a r g e t ( x ∣ z ) u t t a r g e t ( x ) u_t^{target}(x) u t t a r g e t ( x )
损失函数#
我们已经知道对于我们的模型的初始假设:更新时 p t ( x ∣ z ) p_t(x|z) p t ( x ∣ z ) p i n i t p_{init} p ini t δ z \delta_z δ z u t t a r g e t u_t^{target} u t t a r g e t 合适的损失函数 。
Flow Matching#
对于flow model而言,我们的条件是 X 0 ∼ p init , d X t = u t θ ( X t ) d t . X_0 \sim p_{\text{init}}, \quad \mathrm{d}X_t = u_t^\theta(X_t)\, \mathrm{d}t. X 0 ∼ p init , d X t = u t θ ( X t ) d t .
而我们希望有 u t θ ≈ u t t a r g e t u_t^\theta \approx u_t^{target} u t θ ≈ u t t a r g e t 速度场 的L2损失
L F M ( θ ) = E t ∼ U n i f , x ∼ p t [ ∥ u t θ ( x ) − u t t a r g e t ( x ) ∥ 2 ] = E t ∼ U n i f , z ∼ p d a t a , x ∼ p t ( ⋅ ∣ z ) [ ∥ u t θ ( x ) − u t t a r g e t ( x ) ∥ 2 ] \mathcal{L}_{\mathrm{FM}}(\theta) = \mathbb{E}_{t \sim \mathrm{Unif}, x \sim p_t} \bigl[ \| u_t^\theta(x) - u_t^{\mathrm{target}}(x) \|^2 \bigr] \\ = \mathbb{E}_{t \sim \mathrm{Unif}, z \sim p_{\mathrm{data}}, x \sim p_t(\cdot \mid z)} \bigl[ \| u_t^\theta(x) - u_t^{\mathrm{target}}(x) \|^2 \bigr] L FM ( θ ) = E t ∼ Unif , x ∼ p t [ ∥ u t θ ( x ) − u t target ( x ) ∥ 2 ] = E t ∼ Unif , z ∼ p data , x ∼ p t ( ⋅ ∣ z ) [ ∥ u t θ ( x ) − u t target ( x ) ∥ 2 ]
但是这样的损失函数不是特别容易计算,特别是对于 u t target ( x ) = ∫ u t target ( x ∣ z ) p t ( x ∣ z ) p data ( z ) p t ( x ) d z u_t^{\text{target}}(x) = \int u_t^{\text{target}}(x|z) \frac{p_t(x|z)p_{\text{data}}(z)}{p_t(x)} \,\mathrm{d}z u t target ( x ) = ∫ u t target ( x ∣ z ) p t ( x ) p t ( x ∣ z ) p data ( z ) d z u t t a r g e t ( x ∣ z ) u_t^{target}(x|z) u t t a r g e t ( x ∣ z )
L C F M ( θ ) = E t ∼ U n i f , z ∼ p d a t a , x ∼ p t ( ⋅ ∣ z ) [ ∥ u t θ ( x ) − u t t a r g e t ( x ∣ z ) ∥ 2 ] L_{CFM}(\theta)=\mathbb{E}_{t \sim \mathrm{Unif}, z \sim p_{\mathrm{data}}, x \sim p_t(\cdot \mid z)} \bigl[ \| u_t^\theta(x) - u_t^{\mathrm{target}}(x|z) \|^2 \bigr] L CFM ( θ ) = E t ∼ Unif , z ∼ p data , x ∼ p t ( ⋅ ∣ z ) [ ∥ u t θ ( x ) − u t target ( x ∣ z ) ∥ 2 ]
定理3(条件损失等价于边缘损失)
L F M ( θ ) = L C F M ( θ ) + C L_{FM}(\theta)=L_{CFM}(\theta)+C L FM ( θ ) = L CFM ( θ ) + C ∇ θ L F M ( θ ) = ∇ θ L C F M ( θ ) \nabla_{\theta}L_{FM}(\theta)=\nabla_{\theta}L_{CFM}(\theta) ∇ θ L FM ( θ ) = ∇ θ L CFM ( θ )
** Proof:**
L FM ( θ ) = E τ ∼ Unif , x ∼ p ϵ [ ∥ u t θ ( x ) − u t target ( x ) ∥ 2 ] = E τ ∼ Unif , x ∼ p ϵ [ ∥ u t θ ( x ) ∥ 2 − 2 u t θ ( x ) T u t target ( x ) + ∥ u t target ( x ) ∥ 2 ] = E τ ∼ Unif , x ∼ p ϵ [ ∥ u t θ ( x ) ∥ 2 ] 2 E τ ∼ Unif , x ∼ p ϵ [ u t θ ( x ) T u t target ( x ) ] ⏟ = ∫ 0 1 ∫ x p ϵ ( x ) u t θ ( x ) T u t target ( x ) d x d τ = ∫ 0 1 ∫ z ∫ x u t target ( x ∣ z ) p ϵ ( x ∣ z ) p data ( z ) d x d z d τ = E τ ∼ Unif , z ∼ p data , x ∼ p ϵ ( ⋅ ∣ z ) [ u t θ ( x ) T u t target ( x ∣ z ) ] − C 1 = E τ ∼ Unif , z ∼ p data , x ∼ p ϵ ( ⋅ ∣ z ) [ ∥ u t θ ( x ) ∥ 2 − 2 u t θ ( x ) T u t target ( x ∣ z ) + ∥ u t target ( x ∣ z ) ∥ 2 − ∥ u t target ( x ∣ z ) ∥ 2 ] + C 1 = L CFM ( θ ) + C 2 + C 1 , \begin{aligned} \mathcal{L}_{\text{FM}}(\theta) &= \mathbb{E}_{\tau \sim \text{Unif},\, x \sim p_\epsilon} \left[ \| u_t^\theta(x) - u_t^{\text{target}}(x) \|^2 \right] \\ &= \mathbb{E}_{\tau \sim \text{Unif},\, x \sim p_\epsilon} \left[ \| u_t^\theta(x) \|^2 - 2\, u_t^\theta(x)^T u_t^{\text{target}}(x) + \| u_t^{\text{target}}(x) \|^2 \right] \\ &= \mathbb{E}_{\tau \sim \text{Unif},\, x \sim p_\epsilon} \left[ \| u_t^\theta(x) \|^2 \right] 2\underbrace{\mathbb{E}_{\tau \sim \text{Unif},\, x \sim p_\epsilon} \left[ u_t^\theta(x)^T u_t^{\text{target}}(x) \right]}_{\substack{= \displaystyle \int_0^1 \int_x p_\epsilon(x)\, u_t^\theta(x)^T u_t^{\text{target}}(x)\, dx\, d\tau \\ = \displaystyle \int_0^1 \int_z \int_x u_t^{\text{target}}(x|z)\, p_\epsilon(x|z)\, p_{\text{data}}(z)\, dx\, dz\, d\tau \\ = \displaystyle \mathbb{E}_{\tau \sim \text{Unif},\, z \sim p_{\text{data}},\, x \sim p_\epsilon(\cdot|z)} \left[ u_t^\theta(x)^T u_t^{\text{target}}(x|z) \right]}}-C_1 \\ &= \mathbb{E}_{\tau \sim \text{Unif},\, z \sim p_{\text{data}},\, x \sim p_\epsilon(\cdot|z)} \left[ \| u_t^\theta(x) \|^2 - 2\, u_t^\theta(x)^T u_t^{\text{target}}(x|z) + \| u_t^{\text{target}}(x|z) \|^2 - \| u_t^{\text{target}}(x|z) \|^2 \right] + C_1 \\ &= \mathcal{L}_{\text{CFM}}(\theta) + C_2 + C_1, \end{aligned} L FM ( θ ) = E τ ∼ Unif , x ∼ p ϵ [ ∥ u t θ ( x ) − u t target ( x ) ∥ 2 ] = E τ ∼ Unif , x ∼ p ϵ [ ∥ u t θ ( x ) ∥ 2 − 2 u t θ ( x ) T u t target ( x ) + ∥ u t target ( x ) ∥ 2 ] = E τ ∼ Unif , x ∼ p ϵ [ ∥ u t θ ( x ) ∥ 2 ] 2 = ∫ 0 1 ∫ x p ϵ ( x ) u t θ ( x ) T u t target ( x ) d x d τ = ∫ 0 1 ∫ z ∫ x u t target ( x ∣ z ) p ϵ ( x ∣ z ) p data ( z ) d x d z d τ = E τ ∼ Unif , z ∼ p data , x ∼ p ϵ ( ⋅ ∣ z ) [ u t θ ( x ) T u t target ( x ∣ z ) ] E τ ∼ Unif , x ∼ p ϵ [ u t θ ( x ) T u t target ( x ) ] − C 1 = E τ ∼ Unif , z ∼ p data , x ∼ p ϵ ( ⋅ ∣ z ) [ ∥ u t θ ( x ) ∥ 2 − 2 u t θ ( x ) T u t target ( x ∣ z ) + ∥ u t target ( x ∣ z ) ∥ 2 − ∥ u t target ( x ∣ z ) ∥ 2 ] + C 1 = L CFM ( θ ) + C 2 + C 1 ,
因此原本使用 L F M ( θ ) L_{FM}(\theta) L FM ( θ ) L C F M ( θ ) L_{CFM}(\theta) L CFM ( θ )
从而对于Flow matching的训练过程即为
Step 1: initialize with a dataset z~pdata
Step 2:
    for each mini-batch of data:
        sample z from dataset
        sample t from [0,1]
        sample epsilon~N(0,Id)
        sample x~pt(x|z)
        Loss=|u(x)-utargert(x|z)|2
        update the parameters
plaintext
Score Matching#
对于diffusion model而言,我们是通过 d X t = [ u t target ( X t ) + σ t 2 2 ∇ log p t ( X t ) ] d t + σ t d W t \mathrm{d}X_t = \left[ u_t^{\text{target}}(X_t) + \frac{\sigma_t^2}{2} \nabla \log p_t(X_t) \right] \mathrm{d}t + \sigma_t \,\mathrm{d}W_t d X t = [ u t target ( X t ) + 2 σ t 2 ∇ log p t ( X t ) ] d t + σ t d W t ∇ log p t ( X t ) \nabla \log p_t(X_t) ∇ log p t ( X t ) s t θ ( x ) s_t^\theta(x) s t θ ( x ) L S M ( θ ) = E t ∼ U n i f , z ∼ p d a t a , x ∼ p t ( ⋅ ∣ z ) [ ∥ s t θ ( x ) − ∇ log p t ( x ) ∥ 2 ] \mathcal{L}_{\mathrm{SM}}(\theta) = \mathbb{E}_{t \sim \mathrm{Unif}, z \sim p_{\mathrm{data}}, x \sim p_t(\cdot \mid z)} \bigl[ \| s_t^\theta(x) - \nabla \log p_t(x)\|^2 \bigr] L SM ( θ ) = E t ∼ Unif , z ∼ p data , x ∼ p t ( ⋅ ∣ z ) [ ∥ s t θ ( x ) − ∇ log p t ( x ) ∥ 2 ]
类似于上面的讨论,我们可以用同样的定理以及推导方式发现我们只需要去计算
L C S M ( θ ) = E t ∼ U n i f , z ∼ p d a t a , x ∼ p t ( ⋅ ∣ z ) [ ∥ s t θ ( x ) − ∇ log p t ( x ∣ z ) ∥ 2 ] \mathcal{L}_{\mathrm{CSM}}(\theta) = \mathbb{E}_{t \sim \mathrm{Unif}, z \sim p_{\mathrm{data}}, x \sim p_t(\cdot \mid z)} \bigl[ \| s_t^\theta(x) - \nabla \log p_t(x|z)\|^2 \bigr] L CSM ( θ ) = E t ∼ Unif , z ∼ p data , x ∼ p t ( ⋅ ∣ z ) [ ∥ s t θ ( x ) − ∇ log p t ( x ∣ z ) ∥ 2 ]
即可
综上所述,对于Score Matching的训练过程即为
Step 1: initialize with a dataset z~pdata
Step 2:
    for each mini-batch of data:
        sample z from dataset
        sample t from [0,1]
        sample epsilon~N(0,Id)
        sample x~pt(x|z)
        Loss=|s(x)-partial log p(x|z)|2
        update the parameter
plaintext
给定指令下的图片生成#
以上的部分我们使用的数据集默认没有指令,即为 p t θ ( x ∣ ϕ ) p_t^\theta(x|\phi) p t θ ( x ∣ ϕ ) p t θ ( x ∣ y ) p^\theta_t(x|y) p t θ ( x ∣ y )
** guided generative model:**我们的参数为
\begin{align*} \textbf{Neural network:} & \quad u^\theta : \mathbb{R}^d \times \mathcal{Y} \times [0,1] \to \mathbb{R}^d, \; (x, y, t) \mapsto u_t^\theta(x|y) \\ \textbf{Fixed:} & \quad \sigma_t : [0,1] \to (0,\infty), \; t \mapsto \sigma_t \end{align*}
而我们的模型为
\begin{align*} \textbf{Initialization:} & \quad X_0 \sim p_{\text{init}} \\ \textbf{Simulation:} & \quad \mathrm{d}X_t = u^\theta_t(X_t|y)\,\mathrm{d}t + \sigma_t\,\mathrm{d}W_t \\ \textbf{Goal:} & \quad X_1 \sim p_{\text{data}}(\cdot|y) \end{align*}
而我们需要加上指令,只需要在训练的时候将一个输出以及一条指令看成一个pair ,他们是从 ( z , y ) ∼ p d a t a ( z , y ) (z,y)\sim p_{data}(z,y) ( z , y ) ∼ p d a t a ( z , y ) L CFM guided ( θ ) = E ( z , y ) ∼ p data ( z , y ) , t ∼ Unif [ 0 , 1 ) , x ∼ p t ( ⋅ ∣ z ) ∥ u t θ ( x ∣ y ) − u t target ( x ∣ z ) ∥ 2 . \mathcal{L}_{\text{CFM}}^{\text{guided}}(\theta) = \mathbb{E}_{(z,y)\sim p_{\text{data}}(z,y),\, t\sim\text{Unif}[0,1),\, x\sim p_t(\cdot\mid z)} \|u_t^\theta(x\mid y) - u_t^{\text{target}}(x\mid z)\|^2. L CFM guided ( θ ) = E ( z , y ) ∼ p data ( z , y ) , t ∼ Unif [ 0 , 1 ) , x ∼ p t ( ⋅ ∣ z ) ∥ u t θ ( x ∣ y ) − u t target ( x ∣ z ) ∥ 2 .
对于 u t t a r g e t ( x ∣ z ) u_t^{target}(x|z) u t t a r g e t ( x ∣ z ) 图片的提取 ,然后我们的网络会结合y的指令,想办法得到理论上应该在y的条件下产生的图片差不多的图片。从而可以得到我们的结果。
Classifier Free Guidance(CFG)#
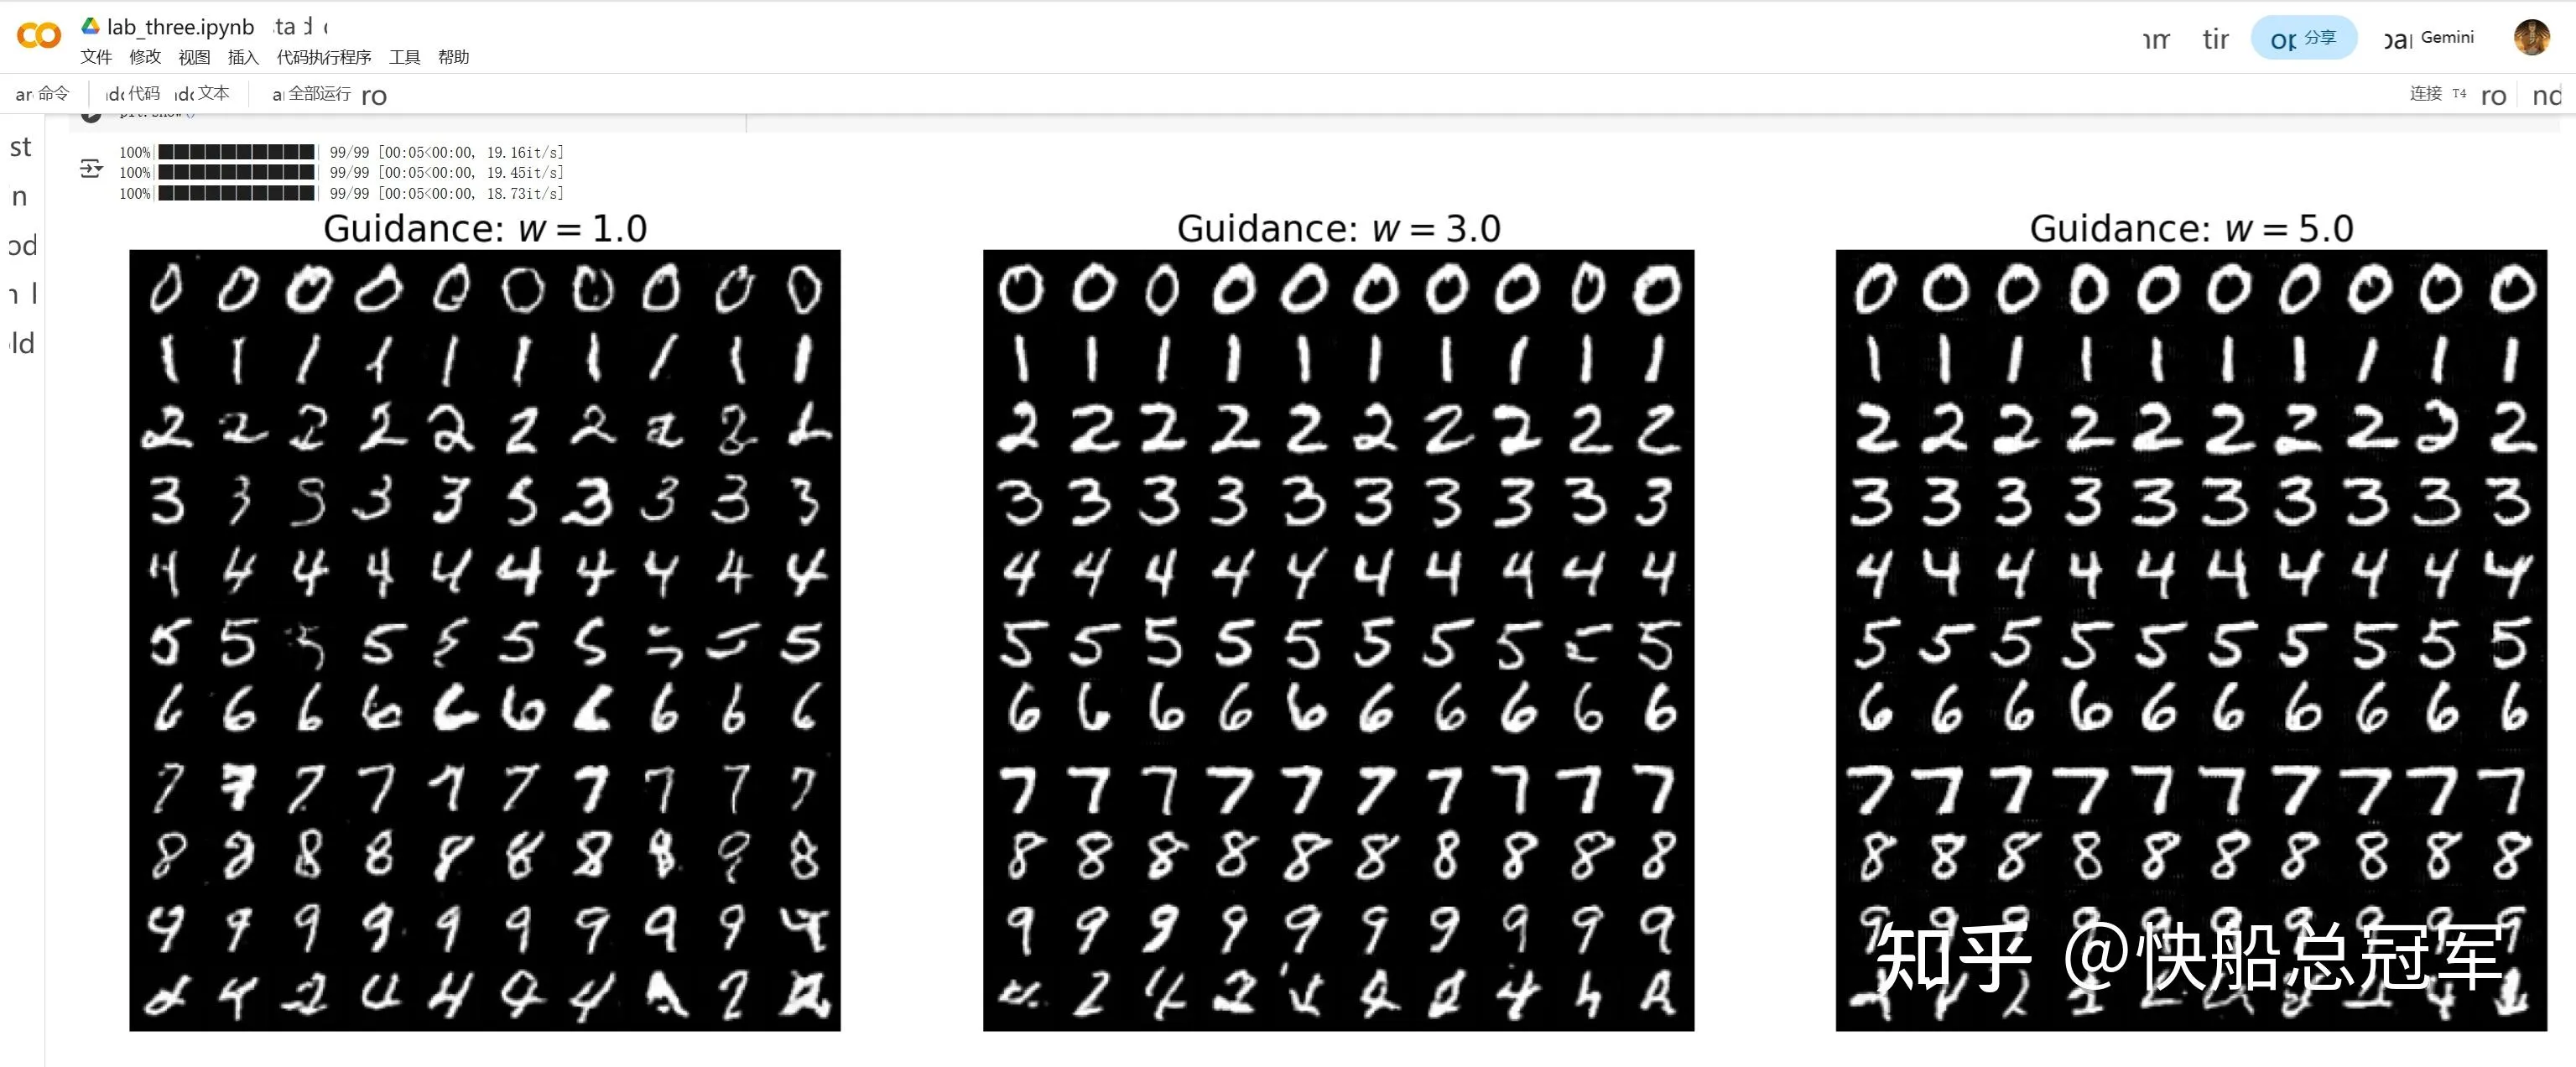
虽然如此,但是我们在实际的应用中发现,如果直接使用这个网络去实现的话,效果不是特别好。我们的策略是奖励通过y的指令的图片,惩罚那些没有通过y的指令的图片 。
具体的过程为
\begin{align*} u_t^{\text{target}}(x|y) &= a_t x + b_t \nabla \log p_t(x|y), \\ &= a_t x + b_t (\nabla \log p_t(x) + \nabla \log p_t(y|x)) = u_t^{\text{target}}(x) + b_t \nabla \log p_t(x|y). \end{align*}
从而对于右侧的一项添加一个guidance scale ,有 u ~ t ( x ∣ y ) = u t target ( x ) + w b t ∇ log p t ( y ∣ x ) \tilde{u}_t(x|y) = u_t^{\text{target}}(x) + w b_t \nabla \log p_t(y|x) u ~ t ( x ∣ y ) = u t target ( x ) + w b t ∇ log p t ( y ∣ x )
这一个权重的原因是因为我们知道 ∇ l o g p t ( y ∣ x ) \nabla log p_t(y|x) ∇ l o g p t ( y ∣ x )
于是我们的w就是让模型知道这个对于y指令非常重要 ,需要添加一个权重,此时我们再带回去,即有
\begin{align*} \tilde{u}_t(x|y) &= u_t^{\text{target}}(x) + w_b t \nabla \log p_t(y|x) \\ &= u_t^{\text{target}}(x) + w_b t (\nabla \log p_t(x|y) - \nabla \log p_t(x)) \\ &= u_t^{\text{target}}(x) - (w_a t x + w_b t \nabla \log p_t(x)) + (w_a t x + w_b t \nabla \log p_t(x|y)) \\ &= (1 - w) u_t^{\text{target}}(x) + w u_t^{\text{target}}(x|y). \end{align*}
此时对于Flow Model而言,在预测的时候,使用 d X t = u t ~ θ ( X t ∣ y ) d t dX_t=\tilde{u_t}^\theta(X_t|y)dt d X t = u t ~ θ ( X t ∣ y ) d t s ~ t θ ( x ∣ y ) = ( 1 − w ) s t θ ( x ∣ ∅ ) + w s t θ ( x ∣ y ) \tilde{s}_t^\theta(x|y) = (1 - w) s_t^\theta(x|\varnothing) + w s_t^\theta(x|y) s ~ t θ ( x ∣ y ) = ( 1 − w ) s t θ ( x ∣ ∅ ) + w s t θ ( x ∣ y ) d X t = [ u ~ t θ ( X t ∣ y ) + σ t 2 2 s ~ t θ ( X t ∣ y ) ] d t + σ t d W t \mathrm{d}X_t = \left[ \tilde{u}_t^\theta(X_t|y) + \frac{\sigma_t^2}{2} \tilde{s}_t^\theta(X_t|y) \right] \mathrm{d}t + \sigma_t \mathrm{d}W_t d X t = [ u ~ t θ ( X t ∣ y ) + 2 σ t 2 s ~ t θ ( X t ∣ y ) ] d t + σ t d W t
Example: Gaussian probability path#
由于我们能想到的最简单的分布就是高斯分布 ,高斯分布作为 p t ( x ∣ z ) p_t(x|z) p t ( x ∣ z ) p t ( x ∣ z ) = N ( α t z , β t 2 I d ) p_t(x|z)=\mathcal{N}(\alpha_t z,\beta^2_t I_d) p t ( x ∣ z ) = N ( α t z , β t 2 I d ) u t t a r g e t ( x ∣ z ) , ∇ l o g p t ( x ∣ z ) u_t^{target}(x|z),\nabla log p_t(x|z) u t t a r g e t ( x ∣ z ) , ∇ l o g p t ( x ∣ z )
由 p t ( x ∣ z ) = N ( α t z , β t 2 I d ) p_t(x|z)=\mathcal{N}(\alpha_t z,\beta^2_t I_d) p t ( x ∣ z ) = N ( α t z , β t 2 I d ) x = α t z + β t ϵ , ϵ ∈ N ( 0 , I d ) x=\alpha_t z+\beta_t \epsilon,\epsilon\in N(0,I_d) x = α t z + β t ϵ , ϵ ∈ N ( 0 , I d )
带入ODE中
α t z + β t x = u t target ( α t z + β t x ∣ z ) for all x , z ∈ R d ⟺ α t z + β t ( x − α t z β t ) = u t target ( x ∣ z ) for all x , z ∈ R d ⟺ ( α t − β t β t α t ) z + β t β t x = u t target ( x ∣ z ) for all x , z ∈ R d \begin{aligned} & \boxed{\alpha_t z + \beta_t x} = u_t^{\text{target}}(\alpha_t z + \beta_t x \mid z) \quad \text{for all } x, z \in \mathbb{R}^d \\ & \iff \alpha_t z + \beta_t \left( \frac{x - \alpha_t z}{\beta_t} \right) = u_t^{\text{target}}(x \mid z) \quad \text{for all } x, z \in \mathbb{R}^d \\ & \iff \left( \alpha_t - \frac{\beta_t}{\beta_t} \alpha_t \right) z + \frac{\beta_t}{\beta_t} x = u_t^{\text{target}}(x \mid z) \quad \text{for all } x, z \in \mathbb{R}^d \end{aligned} α t z + β t x = u t target ( α t z + β t x ∣ z ) for all x , z ∈ R d ⟺ α t z + β t ( β t x − α t z ) = u t target ( x ∣ z ) for all x , z ∈ R d ⟺ ( α t − β t β t α t ) z + β t β t x = u t target ( x ∣ z ) for all x , z ∈ R d
带入道 ∇ l o g p t ( x ∣ z ) \nabla log p_t(x|z) ∇ l o g p t ( x ∣ z ) ∇ log p t ( x ∣ z ) = ∇ log N ( x ; α t z , β t 2 I d ) = − x − α t z β t 2 \nabla \log p_t(x \mid z) = \nabla \log \mathcal{N}(x; \alpha_t z, \beta_t^2 I_d) = -\frac{x - \alpha_t z}{\beta_t^2} ∇ log p t ( x ∣ z ) = ∇ log N ( x ; α t z , β t 2 I d ) = − β t 2 x − α t z
这些即为我们的target的来源,在训练以及预测的时候直接带入即可。
u t θ ( x ) u_t^\theta(x) u t θ ( x ) # 早期的diffusion Model借鉴了U-Nets 的结构Encoder,decoder,midcoder的结构,通过多层的Encoder+CNN+Resets的结构,再通过一个比较小的midcoder,最后以和Encoder同样大小的Decoder把信息进行输出。
而在更加现代化的Diffusion Model中,我们常常使用一些特别的注意力机制 去实现这些功能(具体的以我目前的水平还无法特别好的去理解,之后学完cs224n之后应该可以来完善这一块的内容)
而在为了将我们的指令变成便于计算机理解的“y”,对于主流的模型
stable diffusion: clip&t5-xxl等embedding的方式,同时使用MM-DiT的方式
** Meta Gen Video:**3 embeddings, cross&self attention
最后我们使用MNIST作为数据集,在google colab上使用T4跑了大概5min,得到一个可以生成数字的东西
以上就是对于flow&diffusion model的Generative AI的简介,包括初始的假设,到我们的评判标准,到训练以及预测的过程,可以说是套着边缘分布,使用条件分布去实现的一个非常美丽的模型。
但是对于 u t θ ( x ) u_t^\theta(x) u t θ ( x ) MIT 6.S978 ↗ 去了解。
最后感谢MIT提供的如此优秀的课程,感谢google colab提供的T4, 感谢所有的Mentor和TA做出来的这么美丽的课程,但是要是你们的作业的代码质量更高就好了(我的评价是史山)
附:课程资料MIT 6.S184 ↗